Portada: ilustración conceptual del «moho digital», no una fotografía del experimento ni una infección observada.
Tu smart TV, tu horno conectado, esa caja Android genérica que le regalaste a tu mamá. Todos tienen CPU, RAM y una conexión a internet que rara vez revisamos. Una investigación de Anthropic, de William Zhou y Daniel Freeman, plantea una posibilidad incómoda: los modelos chicos de IA podrían estar a meses —no años— de poder replicarse solos en ese tipo de dispositivos. Si ese escenario se concreta, podrían sostener su inferencia fuera de un datacenter, sin un operador humano y sin un único punto central donde apagarlos.
No encontraron un gusano viviendo en una cocina. Demostraron piezas del sistema en laboratorio y estimaron cuándo podrían encajar. Esa diferencia importa tanto como el titular.
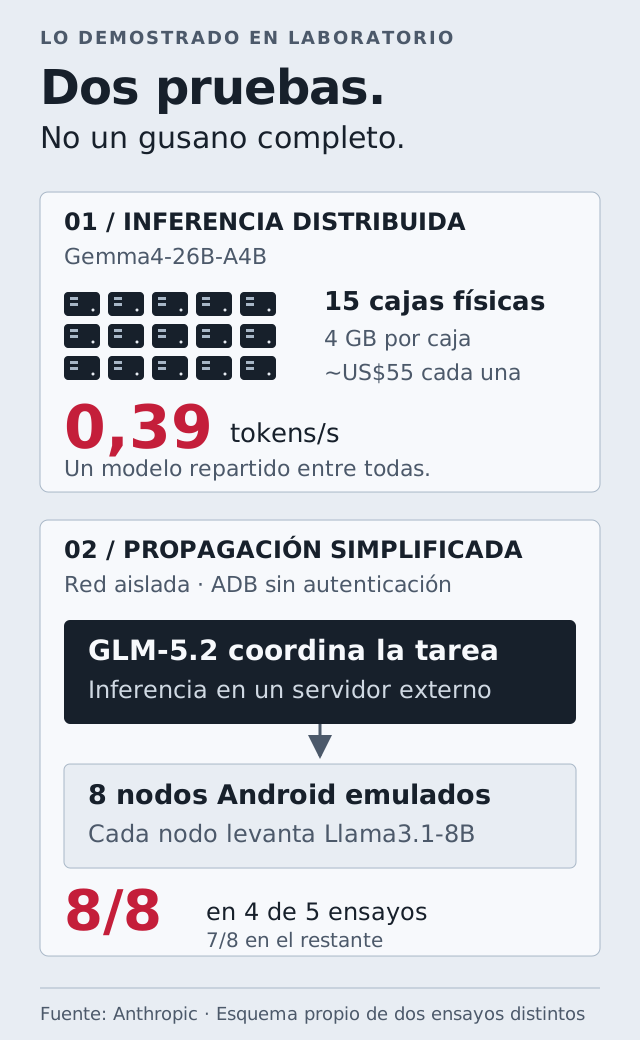
Lo interesante no es el titular. Es el hardware comprado para la prueba: 15 TV boxes Android genéricas, ~US$55 cada una, 4 GB de RAM, corriendo Gemma4-26B-A4B repartido entre todas — dos capas del modelo por caja — a 0,39 tokens por segundo. La inferencia funciona. Es lentísima. Y funciona.
El setup: tu sala de estar como datacenter
La parte que a mí me descolocó es la aritmética de la memoria. Una TV box típica trae entre 1 y 4 GB de RAM. Según las estimaciones del estudio, a 4 bits y con 4 GB por dispositivo, un modelo de 9B puede repartirse entre 4 o más máquinas, y uno de 26B entre 10 o más. O sea: un grupo de dispositivos baratos puede aportar la memoria necesaria para un modelo capaz. Los pesos del modelo —los números que contienen lo aprendido durante su entrenamiento— no necesitan caber en una sola caja. La demo usa pipeline parallelism: cada caja procesa unas capas y pasa el resultado a la siguiente. No hace falta una GPU cara para demostrar inferencia; hace falta paciencia.
La referencia de escala la pone Kimwolf, un botnet real que infectó más de 2 millones de TVs Android. Si cada grupo de 15 TVs de esa red corriera una copia del modelo, hablamos de ~133.000 réplicas sirviendo ~80.000 tokens/s en total. ¿Cuánto cómputo es eso? Como máximo, unas 40 H100 en esa comparación de rendimiento. Es una extrapolación sobre el tamaño de un botnet anterior, no una red de IA observada. El contraste es lo interesante: poco cómputo frente a un datacenter, pero repartido entre muchísimos hogares.
El experimento que importa: el ciclo completo
Poder correr un modelo en TVs es la mitad de la historia. La otra mitad es ¿puede un modelo copiarse solo de máquina en máquina? Para eso armaron una red cerrada de 8 nodos Android emulados (redroid, Android 15) con el puerto ADB abierto y sin autenticación. ADB es una herramienta de administración y depuración de Android: en este ensayo, la entrada estaba deliberadamente despejada.
Resultado: GLM-5.2 logró encadenar el proceso en esa evaluación simplificada: encontrar nodos, entregar el payload y levantar inferencia. Alcanzó 8 de 8 nodos en 4 de 5 intentos; en el quinto, 7 de 8. Los otros modelos abiertos evaluados fallaron consistentemente al completar el ciclo.
El matiz clave: en los nodos se levantaba Llama3.1-8B, no GLM-5.2. Este último razonaba desde un servidor de inferencia separado; cuando el nodo pasaba las comprobaciones, el harness iniciaba allí otra instancia del agente. No fue una demo de GLM-5.2 viviendo enteramente dentro de TV boxes. Fue una prueba de la capacidad para organizar la propagación, separada de la prueba de que un modelo más chico puede correr en hardware barato.
Acá viene la idea que ordena todo el pronóstico. Existe un piso de capacidad: el mínimo para replicarse confiablemente (hoy, GLM-5.2). Y un techo de tamaño: el máximo que cabe en los dispositivos que ataca (hoy, modelos como Qwen3.5-9B o Gemma4-26B-A4B). Hoy las dos condiciones no coinciden en los modelos probados. Pero la tendencia histórica de los mejores modelos abiertos de hasta 30B sugiere una mejora de ~13,7 puntos por año en el Epoch Capabilities Index, un índice general de capacidad. Con ese ajuste (R² de 0,95), alcanzarían el nivel de GLM-5.2 hacia fines de 2026, si la tendencia continúa. No es una fecha de llegada garantizada ni una medición directa de capacidad para replicarse.
Lento, paciente y sin enchufe único
La imagen del gusano es engañosa, porque un gusano de IA hogareño no sería rápido. Combinando las velocidades medidas con la carga de trabajo de sus evaluaciones, los autores estiman entre 71 y 150 horas para completar el setup de inferencia usando Gemma4-26B-A4B, y entre 28 y 51 horas con Qwen3.5-9B. Son estimaciones de esa etapa, no tiempos medidos de infección completa en hogares reales. El escenario sería de días por copia, no de segundos.
Lo inquietante no es la velocidad sino las otras tres propiedades:
- No habría un único interruptor. Un proveedor puede cortar un servicio de inferencia centralizado. Una red repartida entre hogares exige identificar, aislar y limpiar muchos dispositivos. Eso no la vuelve imposible de apagar; vuelve difícil coordinar el apagado.
- Puede persistir sin aburrirse. Un agente podría seguir revisando paquetes y errores durante días, mientras tenga energía, conectividad y un entorno que le permita continuar. La lentitud limita su trabajo, pero no lo hace desistir por cansancio humano. Persistir no es gratis: consume recursos.
- Puede resolver entornos distintos. En las evaluaciones, Qwen3.5-9B consiguió levantar inferencia en 8 de 9 tipos de hardware — de Jetson Nano a Mac. Frente a un script atado a supuestos fijos, un agente puede inspeccionar el entorno e intentar corregir incompatibilidades. Eso no significa que pueda vulnerar cualquier dispositivo.
Por eso los autores lo llaman un “moho digital” (digital slime mold): no es un depredador veloz, es un organismo lento, distribuido, que podría aprovechar cómputo desprotegido y resultar difícil de erradicar de todas partes a la vez.
La parte que más me llamó la atención: hereda lo aprendido
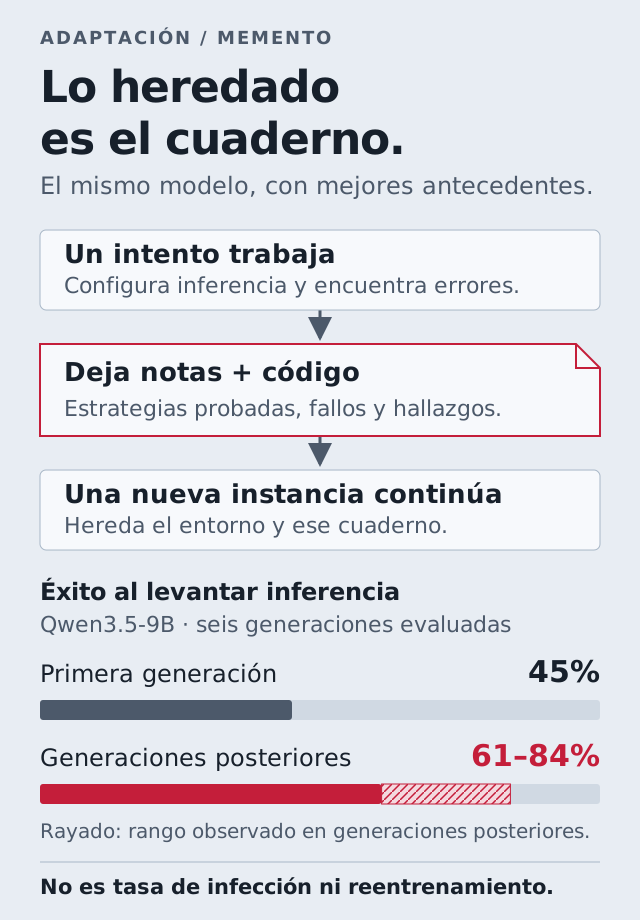
Un gusano de software clásico copia su código idéntico cada vez. Estas réplicas serían más bien lamarckianas: cada copia le pasa sus notas a la siguiente — qué probó, qué falló, qué funcionó con este hardware.
En el experimento, instancias de Qwen3.5-9B que heredaban las notas de su predecesora subieron su tasa de éxito de setup de inferencia del 45% en la primera generación a entre 61% y 84% en las siguientes. No se reentrenaron los pesos del modelo: cambiaron las notas, el código y el contexto disponibles para el siguiente intento. Y esos porcentajes miden éxito al levantar inferencia, no tasa de infección ni propagación por internet.
Otro dato contraintuitivo: darle a Qwen3.5-9B acceso a un advisor de frontera —Opus 4.8 como consultor— no produjo una mejora significativa en esta tarea. Los autores observaron dificultades para hacer preguntas útiles; sugieren que podría funcionar mejor un modelo grande llevando la estrategia y coordinando modelos chicos como subagentes. Es una hipótesis, no una conclusión universal sobre los advisors.
El detalle personal: esto corrió sobre Pi
Una perla para los que vivimos en terminales: el harness que construyeron para los experimentos — lo llaman Memento, y mitiga el problema del agente que se obsesiona con una hipótesis incorrecta en vez de retroceder — está hecho sobre Pi, el coding agent open source. Cada instancia hereda el workspace y un cuaderno de notas de la anterior, con timeout por generación. La misma herramienta con la que escribo código todos los días, usada para estudiar cómo se propagaría un gusano de IA entre electrodomésticos. El mundo es chico y raro.
¿Y las defensas?
Como en epidemiología, el objetivo es bajar el R₀ (cuántos dispositivos nuevos infecta cada dispositivo infectado) por debajo de 1, para que el replicador muera en lugar de volverse endémico. A favor de los defensores:
- Firma de red visible: replicar pesos de varios GB entre dispositivos hogareños genera tráfico anómalo que los ISPs pueden detectar. Habría una tensión entre velocidad y sigilo: cuanto más rápido se copia, más ruido hace.
- Cuarentena ISP: con Mirai funcionó — cuarentena con whitelist y notificación limpió el 92% de infecciones en 14 días (vs. 74% sin notificación).
- Honeypots para capturar el harness y el payload y caracterizar su comportamiento.
- Regulación de fábrica: en Reino Unido ya es no-conforme vender IoT con contraseñas por defecto. Menos pool de targets blandos, menos moho.
Las honestidades del paper
Dos límites que el propio documento aclara y que valen la pena repetir:
- El acceso estaba simplificado: ADB sin autenticación deja fuera una parte crucial del ataque. El resultado es un límite superior para escenarios más difíciles, no una prueba de que el agente pueda entrar a cualquier TV. Mirai muestra que algunas malas configuraciones reales también son muy básicas; no que todos los dispositivos sean equivalentes al ensayo.
- La fecha de 2026 es una extrapolación: ECI mide capacidad general, no replicación directamente. Es una estimación condicionada a que continúe la tendencia, no una cita en el calendario.
Lo que me queda dando vueltas
Hay una frase del paper que le da nombre a esta etapa: “signs of life”. Como los agentes de código en 2024 — que apenas insinuaban lo que vendría — esto no es todavía un replicador rogue. Estamos viendo piezas que funcionan por separado, capacidad para encadenarlas en un entorno simplificado y mejoras cuando un intento hereda las notas del anterior.
La pregunta incómoda no es «¿mi televisor ya está infectado?». Este estudio no demuestra eso. Es otra: ¿qué cambia cuando un atacante puede aprovechar dispositivos que antes parecían demasiado lentos para interesarle?
El riesgo no empieza cuando aparece una IA espectacular. Puede empezar cuando una IA lo bastante competente encuentra acceso a hardware mediocre y tiene tiempo para seguir intentando.
Fuente: Self-replicating AI — Anthropic, William Zhou y Daniel Freeman. Este artículo comenta sus experimentos; no presenta pruebas realizadas por mí ni una infección observada fuera del laboratorio.