Un agente de IA puede entender que alguien quiere cancelar una reserva. Eso no le da permiso para cancelarla.
Parece obvio hasta que un mensaje mezcla una pregunta, un cambio de fecha, una reclamación y una reserva anterior. El modelo ayuda a interpretar esa mezcla, pero no prueba quién escribe, qué reserva está vigente ni si hay confirmación válida para actuar. Y el riesgo no empieza sólo al modificar una reserva: también aparece cuando una etiqueta decide qué respuesta recibe alguien.
Ya conté qué pasa cuando el modelo acierta pero nadie atiende la excepción. En MaltaClean encontré también el error opuesto: un administrador de propiedades que buscaba limpieza recurrente fue clasificado como solicitante de empleo. El modelo reconocía en su explicación que buscaba un servicio para apartamentos, pero la señal de “intención de empleo” activó una respuesta fija de “no hay vacantes”.
El primer error era recuperable: una clasificación contextual equivocada. El segundo lo volvió costoso: el código tomó una etiqueta semántica como autorización para rechazar un posible cliente.
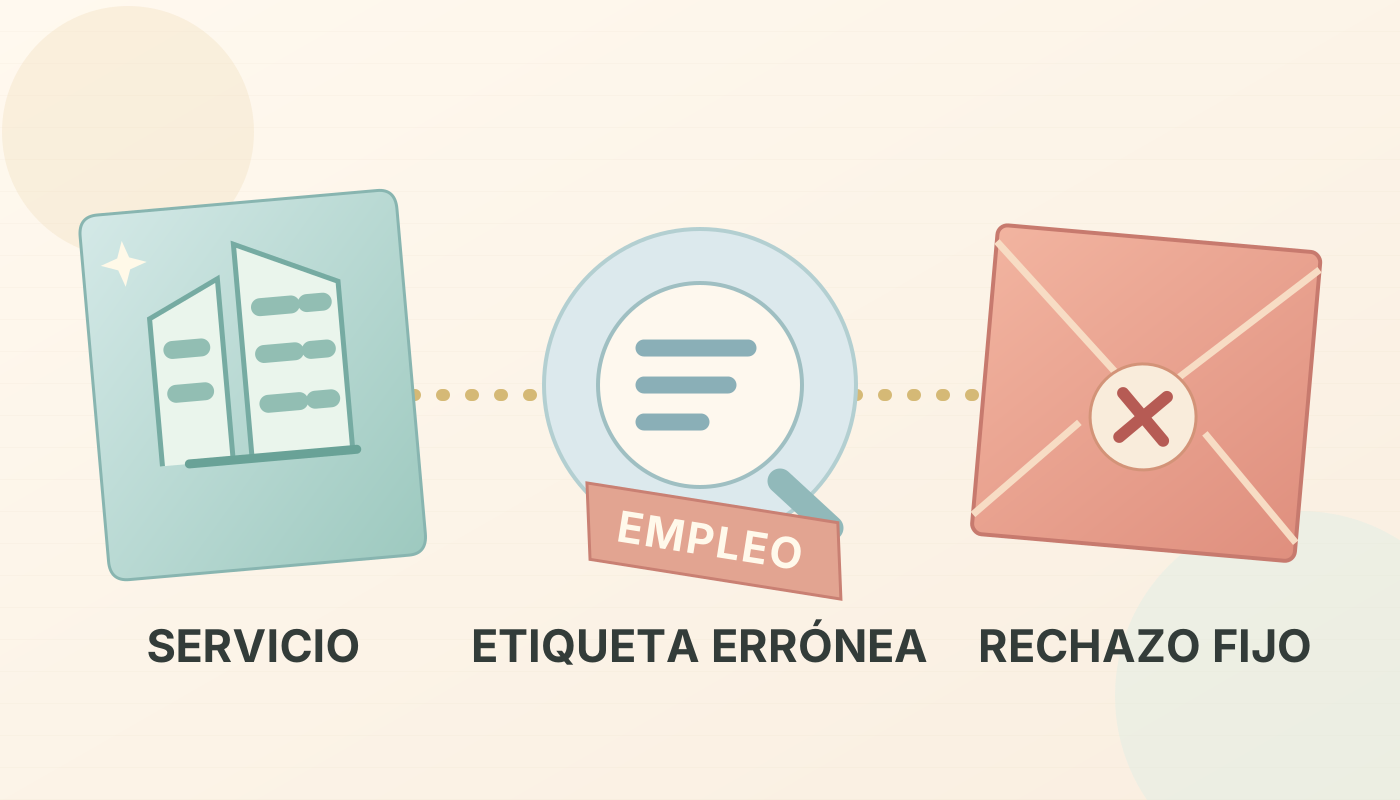
Una etiqueta incorrecta no tendría por qué convertirse en una respuesta automática. Recreación del fallo documentado; no reproduce mensajes ni datos de clientes.
El problema no era tener reglas
Las reglas deterministas no son el enemigo de la IA. Son las que impiden que una respuesta plausible se convierta en una acción incorrecta.
La auditoría revisó en contexto 82 hilos que contenían una decisión del bot o una decisión de recuperación. En 44 había al menos un hallazgo accionable de calidad o una escalación evitable; eso no significa que 44 fueran errores de clasificación.
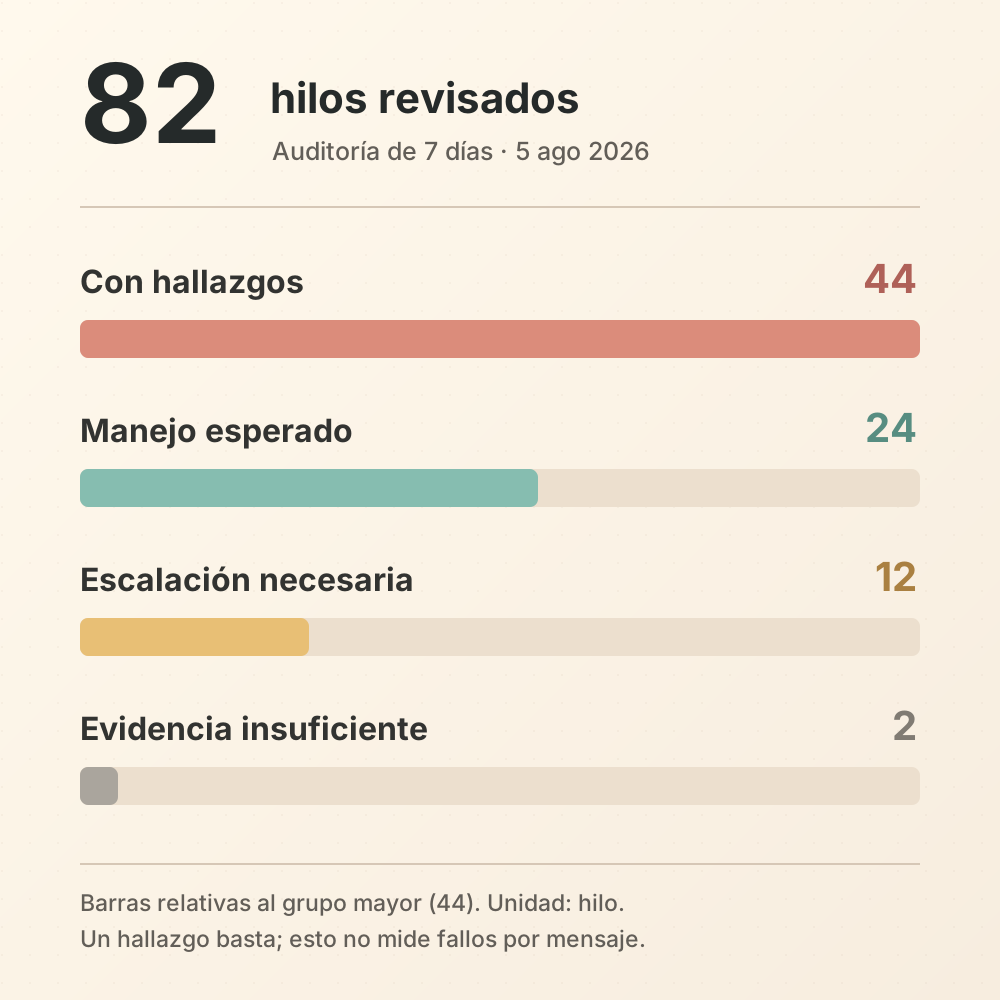
Auditoría de siete días cerrada el 5 de agosto de 2026. Unidad: hilo, no mensaje; basta un hallazgo material para clasificarlo. No mide ventas, causalidad ni la tasa de error del modelo.
En esa misma revisión, las protecciones deterministas funcionaban bien cuando hacían lo que mejor sabe hacer el software:
- entregar datos bancarios desde una fuente canónica;
- comprobar que una reserva pertenece al cliente correcto;
- exigir un token firmado para una cancelación;
- impedir duplicados;
- no afirmar que una mutación ocurrió antes de que el adaptador confirme el resultado.
El fallo aparecía cuando esas reglas intentaban adivinar el significado del mensaje. Un matcher léxico puede encontrar una palabra relacionada con empleo o cancelación, pero no sabe si esa palabra describe el objetivo actual, una experiencia pasada o una excepción dentro de una conversación más amplia.
No había que eliminar las reglas, sino dejar de pedirles que interpretaran conversaciones.
Cuatro decisiones, cuatro dueños
Una arquitectura segura no trata la salida del modelo como un pase libre. Divide el recorrido:
- Modelo contextual — interpreta. ¿Qué parece querer la persona? Propone una intención, pero no modifica datos ni declara éxito.
- Código de autorización — comprueba. ¿Existe permiso y evidencia para ese efecto? Verifica estado, propiedad, datos vigentes y reglas de negocio.
- Adaptador canónico — ejecuta. Aplica validación, deduplicación, auditoría y los efectos secundarios existentes.
- Revisión humana — se hace cargo. Cuando falta certeza o autoridad, el caso sigue visible. Una cola no es prueba de respuesta al cliente.
La separación parece burocrática hasta que se revisa un caso concreto. Si el modelo identifica una solicitud de cancelación, el sistema todavía debe localizar la reserva correcta, comprobar propiedad, emitir o verificar la interacción firmada y releer el estado antes de ejecutarla. Si alguna de esas comprobaciones falla, no hay cancelación “probable”: hay una aclaración o una revisión humana.
Lo mismo ocurre con pagos. Un modelo puede reconocer que un cliente pregunta cómo pagar; el código debe responder con los datos bancarios canónicos. Un modelo puede detectar que alguien dice haber pagado; eso no convierte el pago en validado.
La clasificación es una hipótesis, no una credencial
La clasificación es una hipótesis con alcance limitado: puede distinguir una solicitud de factura, una actualización de reserva o una necesidad de atención humana. No puede, por sí sola, elegir valores que se van a escribir, otorgar permisos ni afirmar un resultado no comprobado.
En MaltaClean, el adaptador recibe una categoría semántica, no una orden del modelo. Los valores de una mutación se fundamentan de nuevo en el mensaje actual y en el estado operativo. Los efectos pasan por los mismos contratos que ya conocen precios, notificaciones, auditoría e idempotencia.
Ese diseño añade fricción deliberada. Una acción tarda un poco más en cruzar sus límites, pero evita una clase de errores difícil de revertir: la respuesta que suena correcta y cambia algo equivocado.
Qué hacer cuando el modelo no sabe
También es importante decidir qué no hacer durante una caída del proveedor.
La alternativa tentadora es volver a una lista de palabras clave: si el texto contiene “cancelar”, envíalo al flujo de cancelación; si contiene “empleo”, recházalo; si contiene “pago”, marca una intención de pago. La auditoría mostró por qué eso es peligroso: las palabras no llevan por sí solas el contexto que una conversación necesita.
El camino más seguro es devolver un fallo reintentable o crear trabajo de operador cuando falta interpretación confiable. Es menos espectacular que una respuesta automática, pero evita que una interrupción técnica cambie la semántica del producto.
Esto no elimina la automatización. La coloca donde tiene evidencia suficiente: validar una firma, consultar un registro, comparar un estado, calcular un precio desde el catálogo o impedir una repetición. La IA queda para lo ambiguo; el código, para lo comprobable.
La pregunta que cambia el diseño
Cuando evalúe una nueva función con IA, ya no preguntaré primero “¿puede el modelo reconocer esta intención?”. Preguntaré:
- ¿qué hecho independiente necesita la acción?
- ¿quién puede autorizarla?
- ¿qué valores pueden escribirse y de dónde salen?
- ¿qué prueba existe después de ejecutar el efecto?
- ¿qué ocurre si el modelo o el proveedor no están seguros?
La respuesta correcta puede seguir siendo una automatización. Pero será una automatización que conoce su límite.
El modelo puede ayudar a entender una solicitud. El código debe decidir si esa comprensión tiene permiso para convertirse en un efecto.