En la primera parte probé Jev, el modelo de TypeSafe que devuelve decisiones estructuradas en vez de escribir respuestas. Después de 292 casos sintéticos, el resultado prometía: 94,2% de acierto de intención bajo nuestro criterio de evaluación y una latencia p95 de 457 ms en un probe de Workers AI.
Dejé una tarea pendiente: ponerlo junto al concierge de MaltaClean sobre conversaciones reales y contar qué pasaba.
Ya tenemos el corte de once días: 703 turnos de WhatsApp, de 105 teléfonos diferentes, del 20 de septiembre al 1 de octubre. La conclusión es menos espectacular que la del laboratorio, pero más útil: no tengo evidencia para reemplazar al LLM. Sí tengo razones para seguir evaluando Jev como complemento, especialmente cuando el pipeline principal falla. Los últimos días reforzaron esa hipótesis: el 30 de septiembre Jev devolvió clasificaciones en los 45 turnos registrados de esa jornada, aunque ninguna coincidió con la categoría final del pipeline principal.
Y hay una advertencia que importa más que cualquier porcentaje: dos modelos que discrepan no te dicen, por sí solos, cuál tiene razón.
Lo que pusimos en producción —y lo que no
Jev corrió en shadow: recibe una versión del contexto y clasifica en paralelo al sistema actual. Registramos etiquetas, probabilidades, latencia y errores. Su respuesta no cambia el mensaje que recibe el cliente, no crea reservas y no autoriza ninguna acción.
El LLM siguió atendiendo. Jev observó.
Eso permite estudiar discrepancias sin convertir al cliente en el sujeto de un experimento de routing. También limita lo que puedo concluir: este ensayo no demuestra que Jev haya aumentado ventas, reducido esperas o evitado una mala respuesta. No le dimos la oportunidad de producir esos efectos.
La tabla de comparación no guarda nombres, teléfonos ni mensajes; para contar los teléfonos distintos usamos un join interno y exportamos únicamente el agregado. No voy a publicar conversaciones de clientes para ilustrar el ensayo.
El número que sería fácil contar mal
El 26 de septiembre corregimos las preguntas: aclaramos las fronteras entre precio, cotización y disponibilidad; endurecimos el requisito de confirmación de una propuesta; y añadimos una categoría para conversaciones dirigidas al negocio equivocado.
El modelo observado siguió siendo jev-1.13.0. Las preguntas, no.
Por eso separé los resultados:
| Medición | Filas anteriores, sin versión | Preguntas 2.2.0 |
|---|---|---|
| Turnos registrados | 367 | 336 |
| Clasificaciones de Jev recibidas y parseadas | 343 | 326 |
| Coincidencia exacta con el pipeline principal | 52,2% | 26,7% |
Coincidencia cuando el pipeline terminó como provider_valid | 51,5% | 42,6% |
| Latencia p50 / p95 de Jev, solo respuestas exitosas | 545 / 1119 ms | 548 / 1220 ms |
Sería tentador titular: «Jev pasó del 94% al 27%».
Sería incorrecto. El 94,2% del laboratorio mide acierto contra etiquetas del corpus sintético. El 26,7% real mide acuerdo con otro sistema. No son la misma métrica. Si Jev acierta donde el LLM falla, el acuerdo baja. Si ambos cometen el mismo error, el acuerdo sube.
Y aquí el acuerdo cayó sobre todo por el comparador, no por Jev: en el segmento 2.2.0 hubo 131 turnos en los que el pipeline principal declaró proveedor no disponible y respondió con su etiqueta genérica de contingencia. El 30 de septiembre hubo 45 turnos y cero coincidencias. Ese agregado acredita desacuerdo, no que todas las clasificaciones del LLM fueran inválidas ni que Jev tuviera razón. Cuando el pipeline sí terminó como provider_valid, el acuerdo se mantiene en el 42,6%, parecido al 43,9% del corte anterior.
Tampoco puedo decir que las preguntas nuevas empeoraron el modelo: cambió el tráfico y el comparador sufrió una degradación importante.
Cuando el LLM no respondió, Jev muchas veces sí
Este es el hallazgo que los días nuevos hicieron imposible ignorar.
Con las preguntas 2.2.0 hubo 131 turnos en los que el pipeline principal marcó que el proveedor no estaba disponible. Jev entregó una clasificación en 128 de esos 131: 97,7% de disponibilidad en ese subconjunto. Solo falló en tres, por errores de transporte.
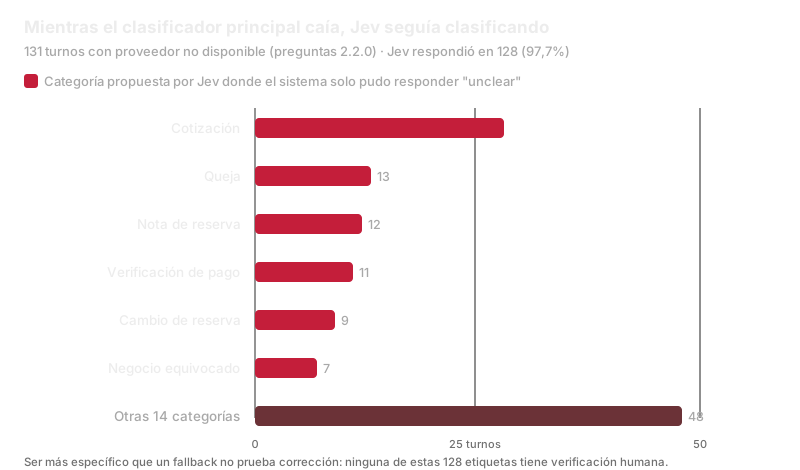
Lo que Jev proponía mientras el sistema solo podía decir “unclear”: cotizaciones, quejas, pagos. Ser más específico que un fallback no prueba corrección.
En esos 131 casos el sistema principal caía en una respuesta de fallback con una etiqueta genérica. Jev proponía categorías más específicas: cotización, queja, cambio de reserva, pago o conversación mal dirigida, entre otras. El pipeline terminó escalando a una persona 171 de las 326 decisiones comparables del segmento (52%). Son las escaladas totales, no 171 fallos del proveedor.
Eso explica la mayor parte del bajo acuerdo: estábamos comparando una decisión de Jev contra una etiqueta de contingencia, no contra una decisión real del LLM.
Pero responder no equivale a acertar. No he demostrado que esas 128 clasificaciones fueran correctas, ni que hubieran permitido atender mejor al cliente. Y ambos usan infraestructura compartida de Cloudflare/Gateway: no es redundancia demostrada frente a cualquier tipo de caída.
Lo que sí cambia es dónde buscar valor. La pregunta ya no es «¿puede Jev clasificar todo primero?», sino «¿puede aportar triage útil cuando el sistema principal se queda sin una clasificación válida?». El 30 de septiembre hubo 45 salidas de Jev para investigar. Que fueran mejores para el cliente sigue siendo una hipótesis.
Velocidad y coste: qué comparo y qué no
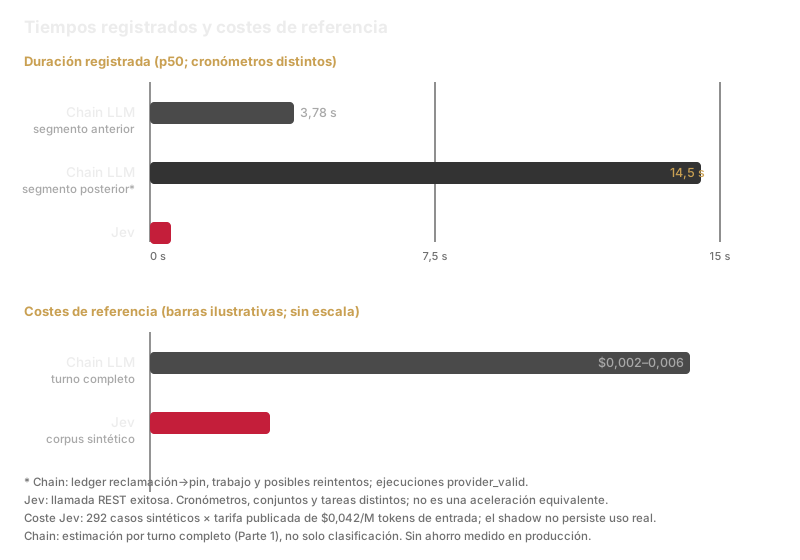
El chain hace más trabajo que Jev —borradores de respuesta, hechos, validación—, así que no es una carrera justa. Para evaluar una posible señal de respaldo, la llamada registrada más corta de Jev es interesante, pero no prueba atención más rápida al cliente ni trabajo equivalente a menor coste.
Los números, con sus asteriscos:
- Tiempo hasta una clasificación válida. En ejecuciones
provider_valid, el ledger mide reclamación→pin por turno: en el segmento anterior, p50 de 3,78 s y p95 de 4,79 s; en el segmento 2.2.0, durante la degradación, el p50 fue de 14,5 s. Ese intervalo incluye trabajo del pipeline y posibles reintentos, no solo inferencia. Jev cronometra su llamada REST en respuestas exitosas: p50 de 548 ms y p95 de 1220 ms. Dividir esas medianas da aproximadamente 7× y 26×, pero compara tareas, cohortes y cronómetros distintos: no demuestra una aceleración equivalente del modelo ni del tiempo que ve el cliente. - Coste por decisión. El chain se estimó en la primera parte entre $0,002 y $0,006 por turno completo. Jev midió $0,000081 por caso en el corpus sintético (tarifa publicada: $0,042 por millón de tokens de entrada, salida gratuita). La relación aritmética es de aproximadamente 25–75×, no un ahorro medido: compara un turno completo estimado con una clasificación sintética medida. El shadow no persiste el uso real de tokens, así que no tengo la factura de esta ventana ni una cifra validada de ahorro en producción.
Las preguntas pequeñas tienen más sentido que el router grande
¿Esta persona está buscando trabajo?
En el segmento actual, el pipeline etiquetó 26 turnos como reclutamiento. La pregunta binaria de Jev marcó los 26. Marcó también siete turnos adicionales.
Es una corroboración fuerte de una distinción importante para una empresa de servicios: alguien que quiere trabajar para ti no es un lead que quiere comprar.
Pero esos siete adicionales todavía son discrepancias por revisar, no «falsos positivos» demostrados. El LLM no se convierte en verdad humana porque sea el sistema que ya teníamos.
¿Necesita una persona ahora?
Con un umbral de 0,7, Jev marcó 35 turnos. El pipeline ya escalaba 34 de ellos.
Es decir: confirma mucho más de lo que descubre. Además, el pipeline escaló 171 turnos en ese segmento — la mayoría durante la degradación —; la señal de Jev solo coincide con 34 de esos 171. No sirve para sustituir el mecanismo completo de handoff.
Al bajar el umbral a 0,5 aparecen doce turnos que el pipeline no escaló. Es ahí donde hace falta una revisión independiente: pueden ser problemas que se nos escaparon, o pueden ser alertas innecesarias.
Una segunda opinión vale cuando distingue errores útiles de ruido, no solo cuando produce otra probabilidad.
Una lección que sí volvió a aparecer: la pregunta importa
La señal ready_to_auto_propose estaba demasiado abierta. Antes marcaba como positivos 152 de 343 turnos: 44,3%, incluyendo turnos escalados o ignorados.
Después de exigir una confirmación explícita de una propuesta concreta, marca 26 de 326: 8,0%.
El cambio es grande. No cambiamos el modelo; cambiamos lo que le pedimos decidir. No atribuyo toda esa diferencia a la redacción: también cambió el tráfico.
Eso todavía no prueba que la señal sea precisa: falta revisar las confirmaciones originales y también los casos que dejó de marcar. Pero muestra por qué un output perfectamente tipado puede seguir siendo semánticamente inadecuado.
«Quiere contratar» y «ha confirmado esta propuesta» no son la misma pregunta. Y ninguna probabilidad autoriza por sí sola una reserva.
Lo que tuve que corregir en mi propia evaluación
El ensayo también expuso límites del instrumento, no solo de Jev.
Las entradas no son totalmente equivalentes. El shadow comparte historia textual y contexto de reservas, pero no recibe todo el contexto operacional ni los píxeles de las imágenes que procesa el LLM. Además, algunas categorías finales son decisiones de código que Jev ni siquiera puede emitir.
Confianza no es calibración demostrada. A mayor confianza declarada, mayor acuerdo con el comparador — del 9,0% bajo 0,5 al 41,9% con 0,9 o más — pero para verificar calibración necesito etiquetas independientes sobre los mensajes reales, no coincidencia con el comparador. Los fallbacks del pipeline contaminan todos los tramos.
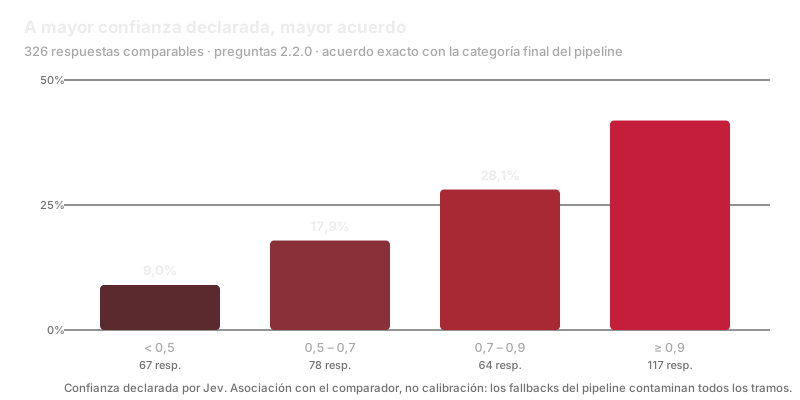
La pendiente existe; la calibración, sin demostrar. El 41,9% es acuerdo en el tramo de confianza ≥0,9, no acierto contra etiquetas humanas. Ni demuestra calibración ni permite declarar que las probabilidades sean incorrectas.
Tipado no es disponibilidad de extremo a extremo. Registramos 34 errores: 20 fueron missing_answers asociados al bug documentado del adaptador durante el arranque; el resto fueron fallos de transporte o HTTP. El modelo puede prometer una forma de salida y mi integración puede leerla mal.
Barato no significa gratis. Cloudflare publica $0,042 por millón de tokens de entrada y salida gratuita. No guardamos el consumo de tokens del shadow, así que no tengo una factura medida para esta ventana. No voy a convertir el coste del corpus sintético en una cifra exacta del tráfico real.
Paralelo no significa cero latencia añadida. El runtime espera de forma acotada al shadow después del clasificador y también espera su escritura en D1. No registramos timeouts de esa espera, pero eso no prueba que nunca añadiera milisegundos. La latencia p95 real de Jev fue 1220 ms con las preguntas actuales; los 457 ms del artículo anterior eran otro benchmark, con estados sintéticos y un camino de ejecución distinto.
Entonces: ¿sirve o no?
Mi decisión hoy es concreta:
- Como reemplazo o router delante del LLM: no lo adopto con esta evidencia.
- Como segunda opinión para investigar errores: sí merece seguir en shadow.
- Como triage auxiliar durante fallos: es la hipótesis con mejor señal nueva, pero falta demostrar que clasifica correctamente.
Tampoco enviaría cada desacuerdo a un humano: con las preguntas actuales sería el 73,3% de las respuestas comparables. Un verificador que convierte casi todo en revisión manual puede añadir trabajo en vez de quitarlo.
Tenemos once días de observación y 703 turnos — el volumen que fijamos para cerrar la fase, aunque no las dos semanas —. Y las preguntas nuevas llevan menos de una semana. Pero esperar más días sin revisar los casos no resolverá la pregunta principal.
El paso que falta es un conjunto de evaluación real, revisado independientemente: acuerdos, desacuerdos, fallos del pipeline y preguntas binarias, con historia y hechos suficientes para juzgar. No solo los ejemplos más llamativos.
Después habrá que medir algo que le importe al negocio: triage correcto, menos alertas inútiles o menor tiempo hasta una atención efectiva. No solo una matriz de dos modelos que discuten.
La tesis, ajustada
En la primera parte escribí que Jev podía completar el stack. Sigo viendo esa posibilidad, pero ahora con una condición más clara:
Una salida tipada garantiza la forma de una decisión, no su verdad ni el valor de actuar sobre ella.
El laboratorio me convenció de probarlo. El tráfico real me mostró que todavía no tengo motivos para entregarle el control. Sí tengo un lugar más concreto para evaluarlo: decisiones pequeñas y una segunda fuente de señales cuando el camino principal falla.
Ese es el resultado de esta segunda parte. No «Jev ganó». No «Jev no sirve». Complemento experimental, con señales prometedoras y límites que ya podemos medir.
Fuentes y método
- Primera parte: TypeSafe Jev.
- Ficha y tarifa del modelo en Cloudflare, consultada el 30 de septiembre de 2026.
- Extracto D1 de solo lectura: ventana solicitada [20 de septiembre 00:00:00, 2 de octubre 17:30:00) UTC. La última fila del shadow observada es del 1 de octubre a las 15:43:33 UTC. Se emparejaron 703 filas de shadow con 761 ejecuciones del clasificador; 58 ejecuciones posteriores no tenían shadow. No hubo filas shadow huérfanas. No conocemos la causa de esa ausencia.
- Los 703 turnos cubiertos corresponden a 105 teléfonos, no a 703 observaciones independientes. 669 respuestas comparables y 34 errores. Rúbricas separadas; sin A/B ni nuevas etiquetas humanas independientes. Latencia del chain: reclamación→pin del ledger en ejecuciones
provider_valid(incluye trabajo del pipeline y posibles reintentos); latencia de Jev: cronómetro de su llamada REST en respuestas exitosas. Los conjuntos y alcances de medición son distintos. - Datos extraídos el 2 de octubre de 2026. La primera lectura, del 30 de septiembre, incluía 623 turnos; esta actualización añade 80 filas de shadow, no nuevas observaciones para todo el 2 de octubre.