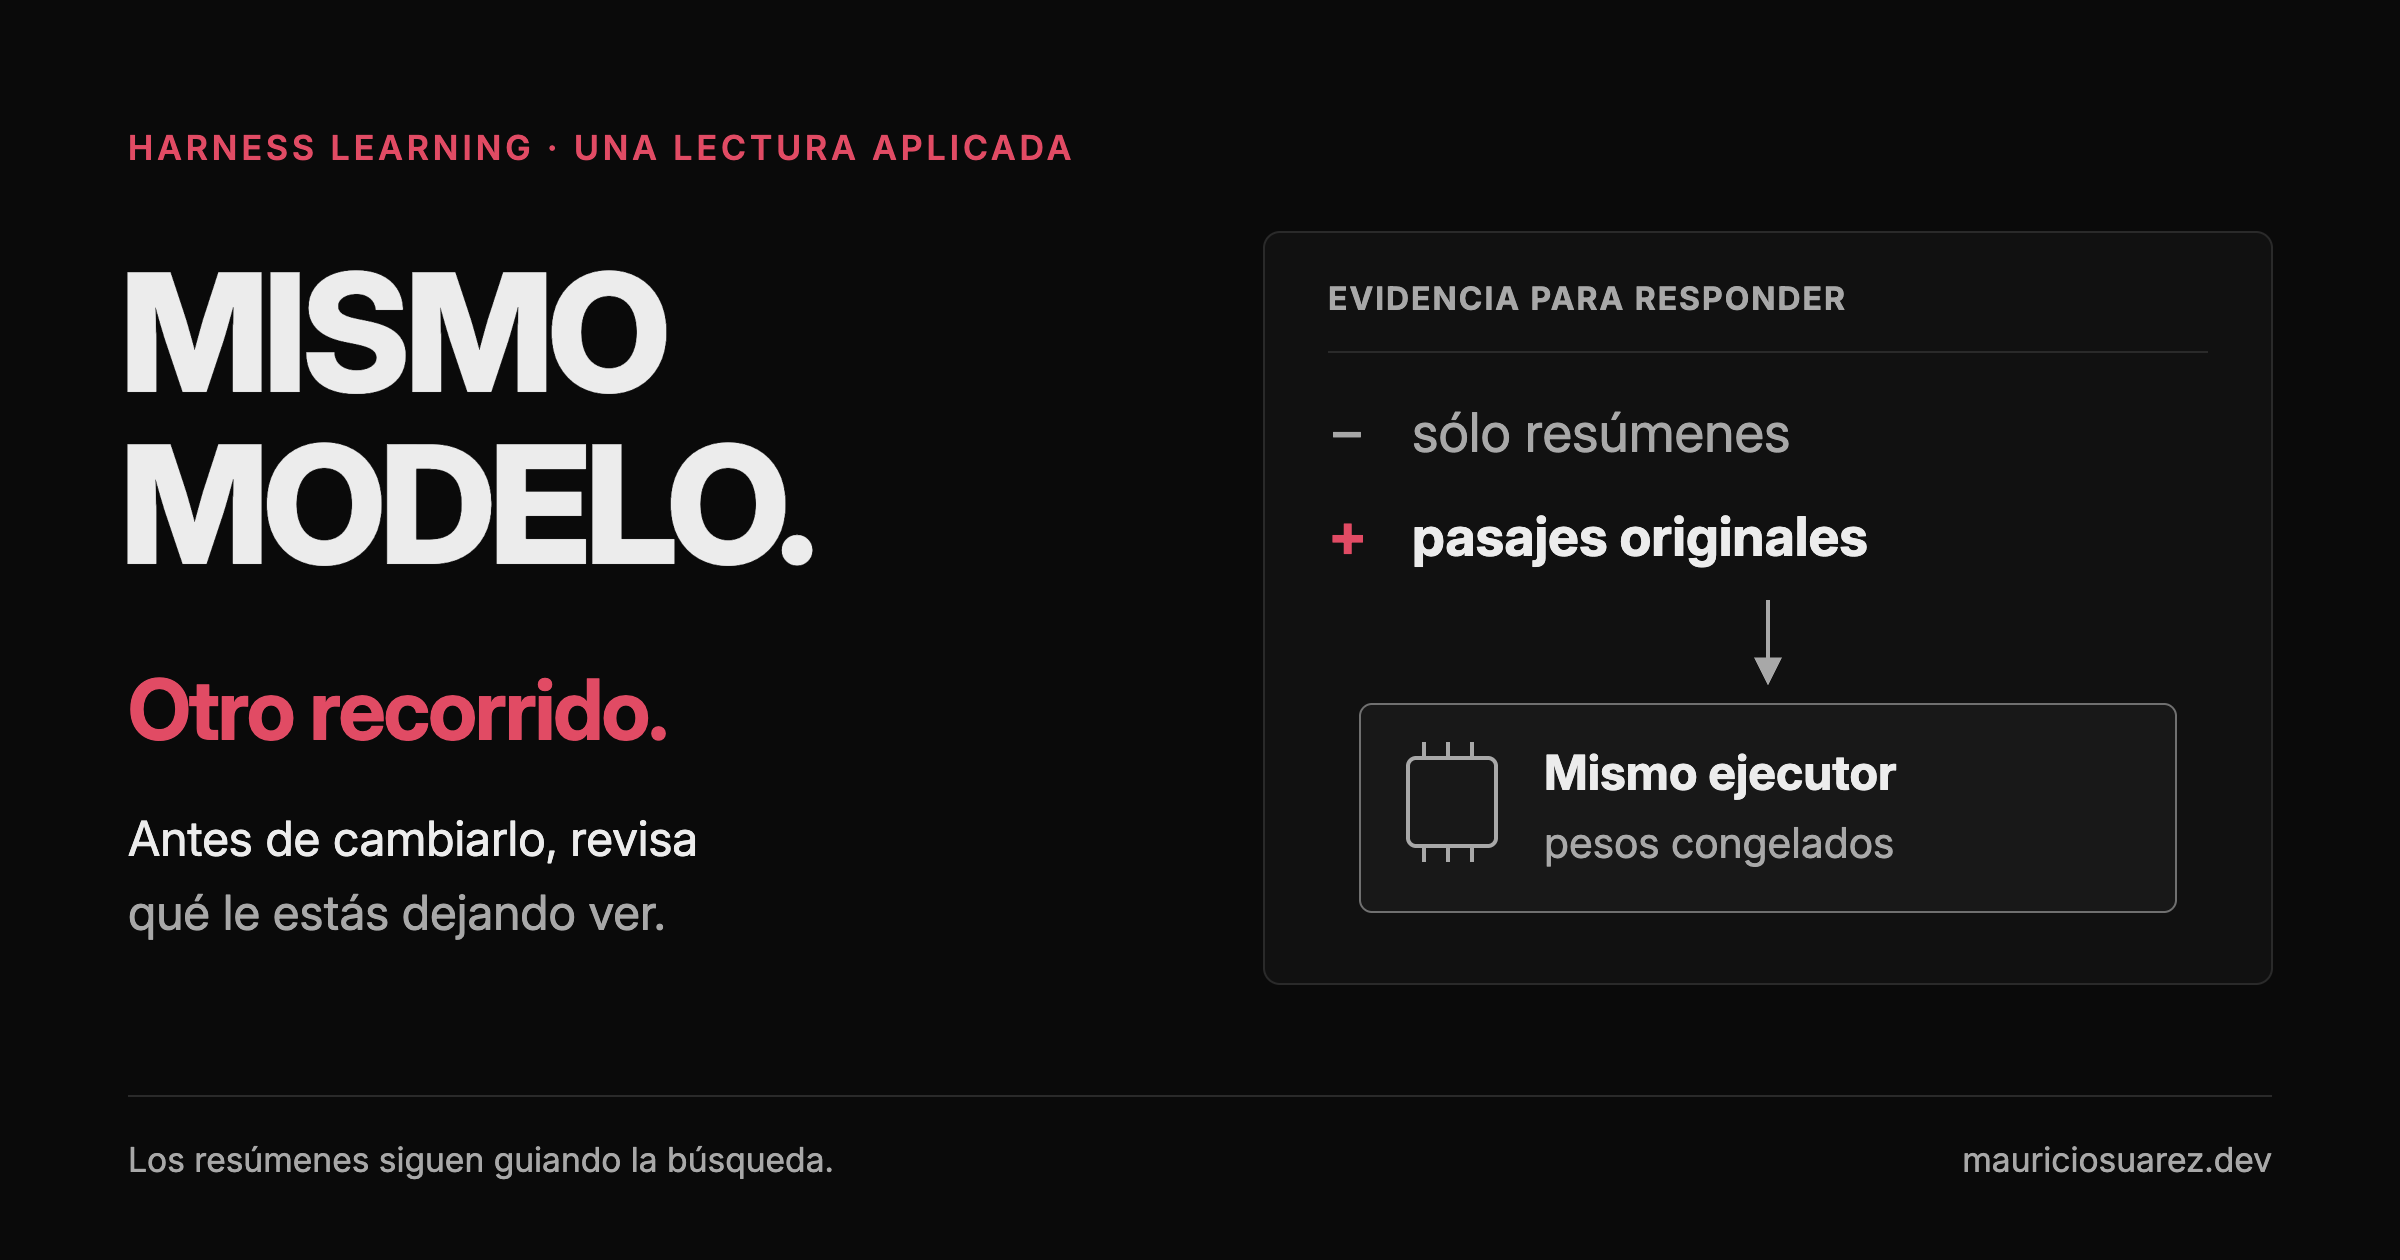
Tu agente responde mal. La reacción más rápida es probar otro modelo.
Antes de hacerlo, revisaría una llamada: la que produce la respuesta final. ¿Qué evidencia recibió?
En los experimentos de preguntas documentales de Harness Learning Enables Generalizable Test-Time Adaptation, el flujo de partida busca documentos, los resume y usa esas síntesis tanto para continuar la búsqueda como para responder.
Una revisión frecuente cambia ese recorrido: mantiene los resúmenes para decidir qué buscar después, pero entrega los pasajes originales a la llamada que responde. El resumen sigue haciendo su trabajo; deja de sustituir a la fuente.
La diferencia importa. Una síntesis útil para buscar puede omitir una condición necesaria para contestar. Y un modelo más capaz tampoco tiene garantizado acertar si esa condición no llega a su contexto.
El paper no mide el efecto aislado de esa modificación. Su pregunta es más amplia: ¿puede un modelo aprender a revisar el procedimiento de un agente a partir de sus fallos, y hacerlo también en tareas nuevas?
Ahí empieza harness learning. Y una pregunta de ingeniería que vale la pena hacer antes de abrir otra pestaña de precios.
Qué es harness learning y qué parte del agente cambia
Un modelo recibe una entrada y genera una salida. Un agente añade decisiones alrededor: cuándo consultar una herramienta, cómo incorporar su resultado, qué conservar del historial, cuándo verificar una respuesta y cuándo volver a intentarlo.
El paper llama harness al programa ejecutable que organiza esas operaciones. Aquí lo llamaré capa de orquestación. Incluye prompts, pero también código, flujo de control, herramientas y circulación de información.
No es lo mismo pedirle al modelo que calcule una respuesta de memoria que permitirle escribir y ejecutar un cálculo. Tampoco es lo mismo responder con un documento completo que con una síntesis que quizá omitió una condición importante. El modelo puede ser idéntico; el sistema que construimos con él, no.
En el artículo sobre nuestro MCP expliqué cómo conectamos a los operadores con funciones delimitadas de MaltaClean. Ese protocolo resuelve una parte de la integración: descubrir e invocar herramientas. Este paper estudia otra pregunta: ¿puede un modelo aprender a revisar el programa que decide cómo utilizarlas?
Tener una herramienta disponible y usarla bien son problemas distintos.
El editor aprende; el ejecutor se mantiene fijo
Los autores separan dos papeles:
- El modelo ejecutor responde las preguntas mediante la capa de orquestación actual.
- El modelo editor, al que llaman proposer, recibe la tarea, el código de esa capa y un informe de ejecución. Su salida es una modificación del programa.
El editor no se limita a decir «razona mejor». Puede cambiar qué llamadas ocurren, añadir una comprobación o reorganizar qué información recibe el ejecutor. Después se ejecuta la propuesta y se evalúan sus resultados.
El ciclo empieza ejecutando el flujo actual sobre preguntas de desarrollo. El editor recibe el código y el informe de resultados y propone modificaciones. El sistema ejecuta y evalúa los programas resultantes. Una selección según el protocolo del experimento determina qué código recibe la siguiente ronda.
El entrenamiento premia al editor por lo que consigue el programa que propone, no por lo convincente que suena la explicación de su cambio. Así aprende una manera de revisar que luego puede aplicarse a tareas nuevas.
En los experimentos de razonamiento, primero lo entrenan con revisiones exitosas de un modelo profesor y después con aprendizaje por refuerzo. En los de preguntas sobre documentos, usan aprendizaje por refuerzo directamente desde el modelo base. La recompensa depende del rendimiento del programa revisado; los protocolos también contemplan su validez y ejecución.
Hay una distinción importante: sí hay entrenamiento previo. Lo que permanece fijo durante la adaptación a una nueva tarea son los parámetros de ambos modelos. El editor sigue cambiando el programa, no sus propios pesos ni los del ejecutor.
Por eso «mejorar sin cambiar de modelo» no significa «mejorar sin entrenamiento, pruebas ni coste».
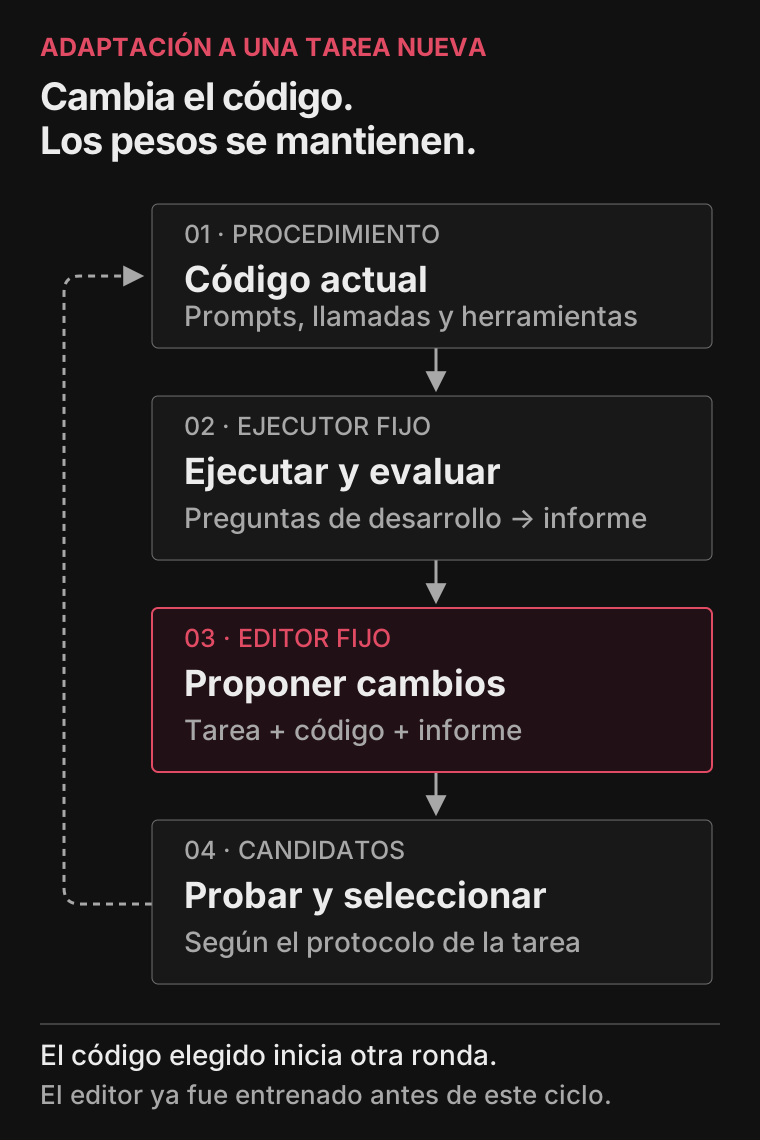
Esquema del ciclo de adaptación descrito en la sección 4.2. El editor se entrena antes; aquí modifica código, no pesos. La selección depende del protocolo y no garantiza que cada ronda mejore.
El resultado mejora. El control también importa
En Reasoning Gym, un conjunto de tareas sintéticas de razonamiento, el resultado destacado es una subida de 0,32 a 0,62 en la puntuación media de las revisiones individuales sobre 21 familias que no habían aparecido en el entrenamiento del editor.
La comparación es entre las propuestas del editor base y las del editor entrenado, manteniendo fijo el ejecutor. Evalúan ocho revisiones independientes por familia sobre 75 preguntas reservadas, distintas de las usadas para dar feedback y seleccionar durante la adaptación. No están comparando simplemente un agente antes y después de una modificación, ni midiendo una tasa de éxito en producción.
También importa el denominador. El apéndice B.1 explica que la comparación principal excluye cinco familias difíciles para los modelos evaluados. Al incluir las 26 familias no vistas, la media pasa de 0,282 a 0,528. La mejora sigue ahí, pero es menor que la cifra destacada.
Y hay un control que merece salir del apéndice: en esas 21 familias, un flujo fijo que permite ejecutar Python durante hasta cinco turnos obtiene 0,69, frente al 0,62 medio de las revisiones del editor entrenado, según la tabla 9.
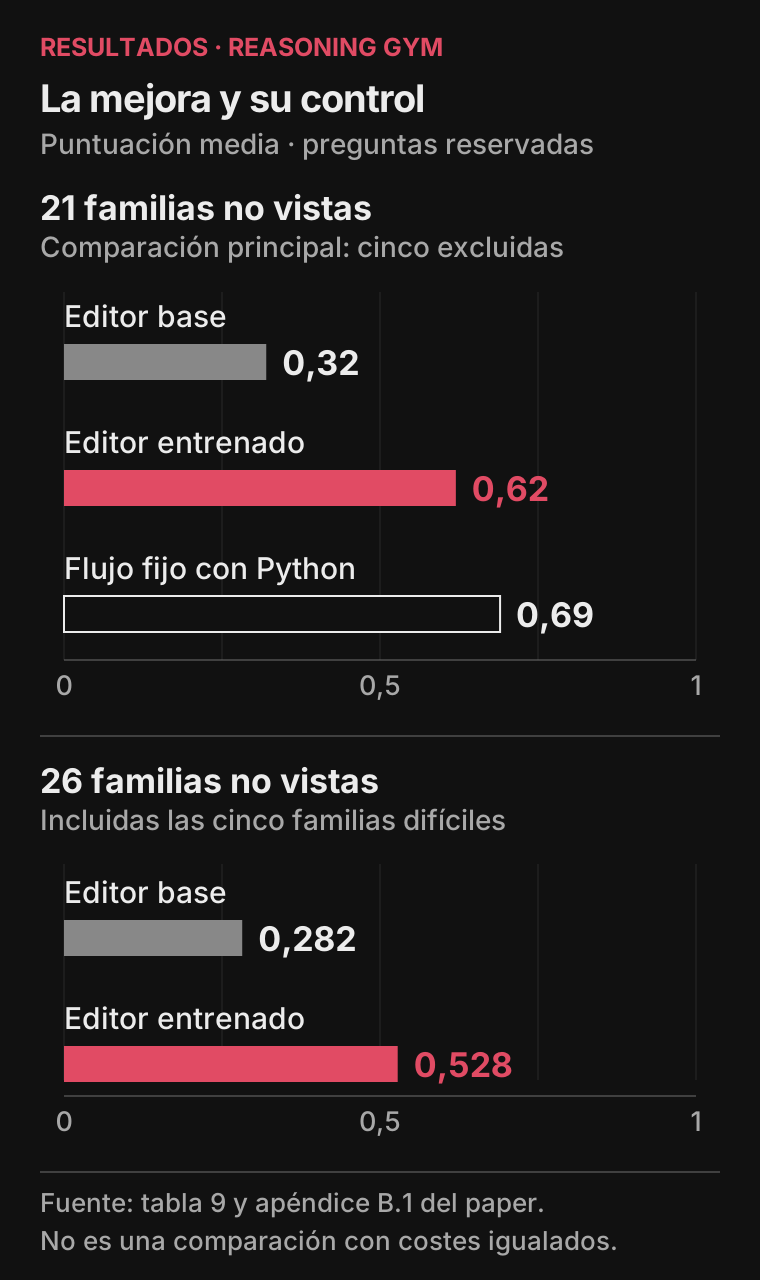
Datos de la tabla 9 y el apéndice B.1: medias de revisiones individuales, no selección de la mejor propuesta. El control con Python es un flujo fijo. Los paneles separan los conjuntos de 21 y 26 familias; no miden ventas, ahorro ni rendimiento con costes igualados.
Eso no iguala todos los presupuestos de cómputo ni resuelve cuál es mejor en cada tarea. Sí impide una lectura demasiado cómoda: aprender a modificar el flujo no demuestra que siempre sea mejor que diseñar uno sencillo y fijo.
Ese control cambia la decisión práctica. Si un flujo fijo con una herramienta bien integrada ya resuelve tu problema, el editor automático tiene que justificar su complejidad. El estudio muestra que el editor puede aprender a proponer mejor; no que sea siempre la forma más sencilla de conseguir un buen agente.
La transferencia es más interesante que el titular
En las pruebas de preguntas que requieren varias búsquedas, el editor se entrena sobre HotpotQA y luego se evalúa sobre MuSiQue y 2WikiMultihopQA, dos benchmarks no usados en ese entrenamiento. Los editores entrenados mejoran los flujos también en esos conjuntos.
Además, un editor entrenado para hacer revisiones individuales puede seguir siendo útil en rondas sucesivas, cuando el código que recibe ya contiene sus propias modificaciones. No necesita haber sido entrenado sobre cada estado intermedio exacto para producir nuevas mejoras en estos experimentos.
Eso es una señal de transferencia de la capacidad de revisión. No es prueba de que pueda mejorar cualquier agente o aprender indefinidamente de cualquier conversación.
Hay dos límites que conviene conservar: entrenar con secuencias de revisiones no ofrece una ventaja consistente frente a entrenar revisiones individuales; y la comparación secuencial de preguntas documentales iguala el número de propuestas, no todo el cómputo ni todo el feedback.
El editor puede seguir siendo útil mientras cambia el programa. Que ese proceso compense económicamente necesita otra evaluación.
Cuatro comprobaciones antes de añadir otro modelo
No empezaría reproduciendo el entrenamiento del paper. Primero seguiría el recorrido de una respuesta fallida.
¿Dónde se pierde la evidencia? El ejemplo de los documentos da una pista concreta. Una síntesis puede ser suficiente para elegir la próxima búsqueda y demasiado pobre para justificar la respuesta final. Revisaría qué datos originales, referencias y condiciones llegan a cada decisión, en lugar de asumir que un resumen sirve para todo.
¿Qué trabajo debería hacer una herramienta? En las tareas de razonamiento, muchas revisiones introducen ciclos de ejecución de código. La lección aplicable no es que todo agente deba tener un intérprete: es comprobar si estamos pidiendo al modelo que improvise algo que el software ya sabe calcular o verificar.
¿Qué llamamos una mejora? Elegir una revisión porque se ve mejor sobre los mismos ejemplos que la inspiraron puede recompensar el ajuste a esos ejemplos. El paper separa las preguntas reservadas para evaluar del material usado durante la adaptación. En una aplicación haría esa misma separación con casos de uso y fallos conocidos, midiendo también latencia, coste y efectos no deseados.
¿Cuándo se detiene la búsqueda? Cada candidato exige ejecución y evaluación. Antes de automatizar revisiones, definiría un presupuesto y compararía el resultado con el flujo fijo más simple que tenga sentido. Una mejora pequeña puede no justificar otra capa operativa.
Son aplicaciones que propongo a partir de la lectura, no cambios que hayamos implementado ni resultados que hayamos medido en MaltaClean.
Cambiar el procedimiento no concede permisos
Hay una frontera que este tipo de trabajo no debería borrar: una buena puntuación no autoriza a un agente a cambiar las reglas que protegen una operación.
En el artículo sobre intención y autorización separé comprender una solicitud de tener permiso para ejecutarla. Un editor del flujo debería seguir sujeto a esa separación. Reorganizar una búsqueda no es lo mismo que eliminar una confirmación de pago o ampliar el acceso a conversaciones.
Si trasladara esta idea a un sistema con consecuencias reales, probaría las modificaciones en un entorno aislado, con acceso limitado y sin credenciales operativas. Los controles de autorización y los contratos de efectos quedarían fuera de lo que el editor puede modificar. Promover una revisión a producción requeriría sus propias pruebas y revisión.
Eso es una recomendación de ingeniería, no una garantía de seguridad demostrada por estos benchmarks. Los experimentos principales estudian razonamiento y preguntas sobre documentos; no certifican que un editor pueda gestionar reservas, dinero o permisos de forma segura.
Abre la traza antes de cambiar el modelo
Harness learning muestra que un editor entrenado puede producir revisiones mejores y transferir esa capacidad a ciertas tareas nuevas, con el ejecutor fijo. No convierte el cambio de modelo en una decisión equivocada.
Mi conclusión práctica empieza antes: abre la traza de una respuesta fallida y mira qué recibió la última llamada. Después comprueba qué herramienta podía consultar y qué verificación faltó.
Quizá necesites un modelo más capaz. Quizá sólo necesites dejar de pedirle que responda desde un resumen que ya perdió la evidencia. Corregir ese recorrido puede requerir unas líneas de código, no un sistema que aprenda a reescribirse.
Cambiar de modelo sigue siendo una opción. Entender por qué falló el agente debería ser el paso anterior.
Fuente: Alvin Zhang y colaboradores, Harness Learning Enables Generalizable Test-Time Adaptation, arXiv:2609.35738v1, 28 de septiembre de 2026. El ejemplo documental corresponde a la sección 6.2; los resultados y la adaptación sucesiva, a las secciones 5.2–5.4; las exclusiones y el flujo fijo con Python, al apéndice B.1 y la tabla 9. Este artículo distingue los resultados del estudio de mis propuestas para aplicarlos.