La propuesta parecía difícil de rechazar: menos proveedores, menos piezas que mantener y modelos de IA con un costo estimado muy bajo. Entonces apareció una cifra en la prueba del clasificador de MaltaClean: el mejor candidato acertó formato, decisión y categoría a la vez en sólo cuatro de ocho casos.
Ningún cliente recibió esas respuestas. Estábamos probando una posible migración en un entorno de evaluación, no cambiando el bot en producción. Pero el resultado alteró la pregunta. Ya no era «¿cuánto ahorraríamos por llamada al modelo?», sino «¿qué decisiones equivocadas permitiríamos a cambio?».
La oferta era simplificar, no sólo pagar menos
En agosto de 2026 evaluamos sustituir los modelos que interpretaban los mensajes del concierge por alternativas alojadas en Workers AI. La idea prometía reducir la cadena de proveedores y acercar texto, audio e imagen a un mismo plano de control. Los precios publicados hacían atractiva la cuenta por turno; no teníamos aún una comparación de facturas reales que demostrara un ahorro neto.
El clasificador no escribe reservas ni valida pagos. Propone qué significa un mensaje y qué camino tomar: responder, pedir datos o derivar el caso a una persona. Luego el código comprueba permisos, estado y efectos. Esa separación, que expliqué en el artículo sobre intención y autorización, limita el daño de una salida mala. No vuelve inocua una clasificación incorrecta: la etiqueta todavía puede decidir si alguien recibe ayuda o una respuesta automática fuera de lugar.
Por eso la comparación no podía reducirse a precio por millón de tokens. Había que someter los candidatos a decisiones que el sistema ya sabía evaluar.
Ocho casos, cuatro candidatos y una señal clara
El 7 de agosto ejecutamos el prompt del clasificador con ocho casos de texto del corpus de evaluación, cada uno con una decisión y una categoría esperadas. Excluimos dos casos que el propio sistema bloquea antes de llamar al modelo y uno de imagen sin archivo visual para esa prueba. En la ronda comparable, cuatro modelos no razonadores recibieron los mismos ocho casos.
La medida crítica exigía tres cosas a la vez: JSON con los campos requeridos, la decisión esperada y la categoría esperada. No medía una venta, una conversación completa ni la experiencia posterior del cliente.
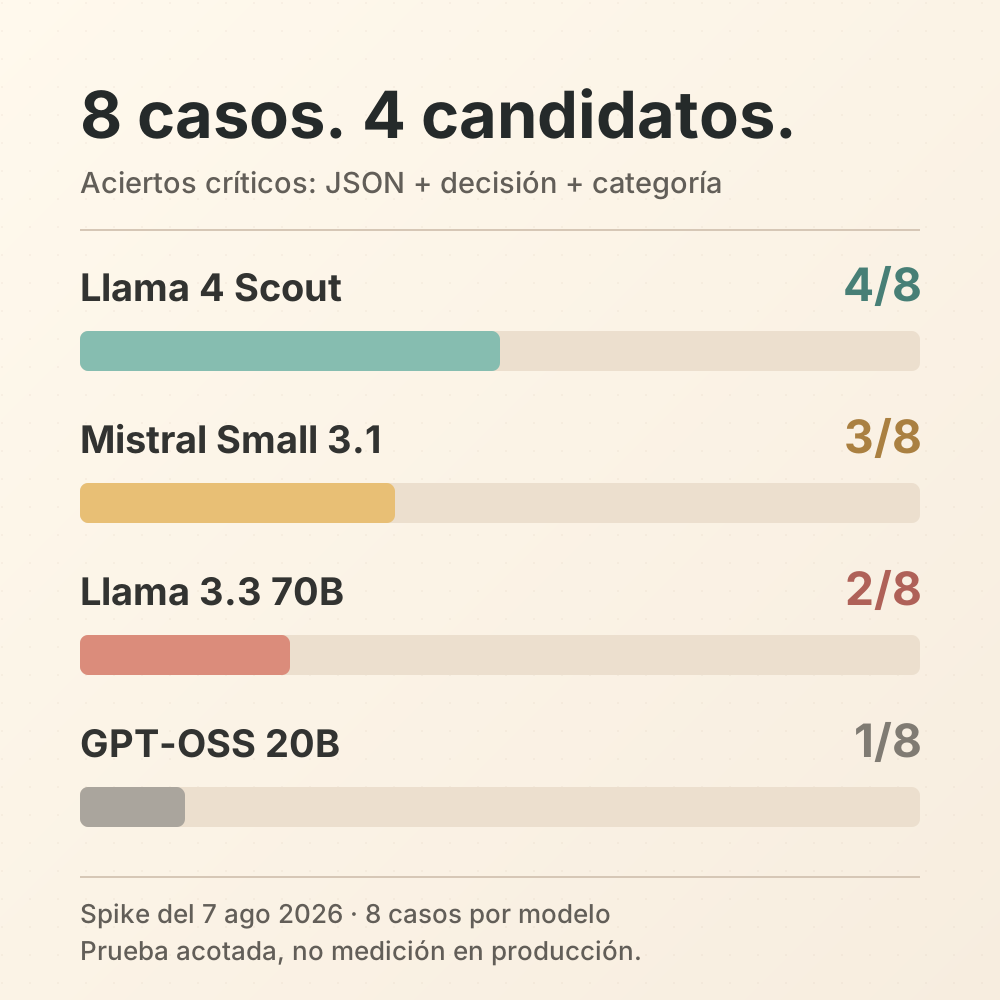
Prueba interna del 7 de agosto de 2026. Ocho casos puntuados por modelo; cada barra cuenta aciertos conjuntos de formato, decisión y categoría. No es una tasa de error en producción ni una estimación poblacional.
Llama 4 Scout, el mejor de esa ronda, obtuvo 4/8 en la medida crítica y 7/8 en JSON válido con los campos exigidos. Mistral Small 3.1 obtuvo 3/8 en la medida crítica aun con 8/8 en JSON. La diferencia importa: un mensaje puede venir perfectamente empaquetado y seguir tomando la ruta equivocada.
También ensayamos dos variantes razonadoras en una ronda previa de diez casos. No las mezclo en el gráfico: tenían otro denominador, y sus problemas de formato y latencia se examinaron aparte. El gráfico sólo compara candidatos probados sobre los mismos ocho casos.
La respuesta que debía esperar a una persona
Un caso de evaluación planteaba una consulta de empleo con una cuestión sobre permiso de trabajo. La ruta esperada era derivar a un operador. Tres de los cuatro candidatos de la ronda de ocho casos eligieron, en cambio, responder automáticamente.
No estoy describiendo un mensaje real enviado por el concierge ni reproduciendo el texto de una persona. Era un caso de prueba. Precisamente para eso sirve un caso así: hace visible una decisión que no conviene descubrir después de un despliegue. Una respuesta fluida puede parecer una buena atención mientras evita la revisión que el equipo había definido para esa situación.
En otro tipo de caso, pedir datos para preparar una cotización y contestar de inmediato no son la misma decisión. Algunas diferencias de etiqueta podrían merecer discusión humana; la ruta de empleo era una señal más difícil de ignorar. El problema no era que el modelo costara poco, sino que el ahorro dependía de ponerlo en una posición de autoridad que la prueba no justificaba.
Arreglar el JSON no arregló el juicio
Había una objeción razonable: ¿y si el resultado mejoraba al exigir un esquema JSON estricto? Volvimos a probar los dos mejores candidatos. Ambos entregaron 8/8 respuestas con JSON válido y los campos requeridos. Sin embargo, Llama 4 Scout pasó de 4/8 a 2/8 en la medida crítica; Mistral Small 3.1 se mantuvo en 3/8.
Un esquema puede impedir que el modelo invente una categoría fuera de la lista. No puede garantizar que elija la decisión correcta entre «responder», «pedir información» y «escalar». Confundir la forma con el criterio habría producido una demo más limpia, no un clasificador más confiable.
Decir que no también necesita límites
La decisión de agosto fue no migrar el clasificador autoritativo de texto a esos candidatos de Workers AI en esa configuración. No fue un veto a la plataforma ni una prueba de que ningún modelo futuro pueda servir. Otros usos, como transcripción o ayudas que no deciden el resultado de un cliente, requieren evaluaciones propias; aprobarlos no equivale a promover el clasificador.
Tampoco hay que convertir ocho casos en una gran estadística. Los criterios de promoción a producción contemplaban al menos 99,9 % de clasificación válida y protegida —o escalación segura— y 99,9 % de validez de esquema, además de controles de seguridad. El indicador crítico del spike era un filtro más estrecho, no la misma métrica operativa. Con ocho ejemplos no se puede certificar un umbral de 99,9 %, ni estimar una tasa de error de producción. El prompt era el de producción, afinado para los modelos anteriores; un prompt adaptado podría cambiar los resultados. Tampoco corrimos esos modelos como línea base sobre los mismos casos: la prueba descarta la promoción de lo ensayado, pero no mide una ventaja porcentual entre proveedores.
Si volviéramos a evaluar la migración, pediría cinco pruebas antes de hablar de ahorro:
- Un corpus más amplio con decisiones de riesgo y salidas esperadas, incluidas las que deben llegar a una persona.
- Formato y decisión semántica medidos por separado; un JSON correcto no basta.
- Candidatos y línea base ejecutados sobre los mismos casos, con condiciones comparables.
- Costo por turno válido, incluidos reintentos y escalaciones, no sólo precio por token.
- Evidencia de privacidad, latencia y reversión antes de confiarle tráfico real.
La prueba no demostró que la arquitectura anterior fuera perfecta ni que los modelos baratos fueran inútiles. Demostró algo más concreto: la oferta económica no había ganado todavía el derecho a decidir qué conversación podía resolverse sola. Por eso, aquel día, no migrar fue avanzar.