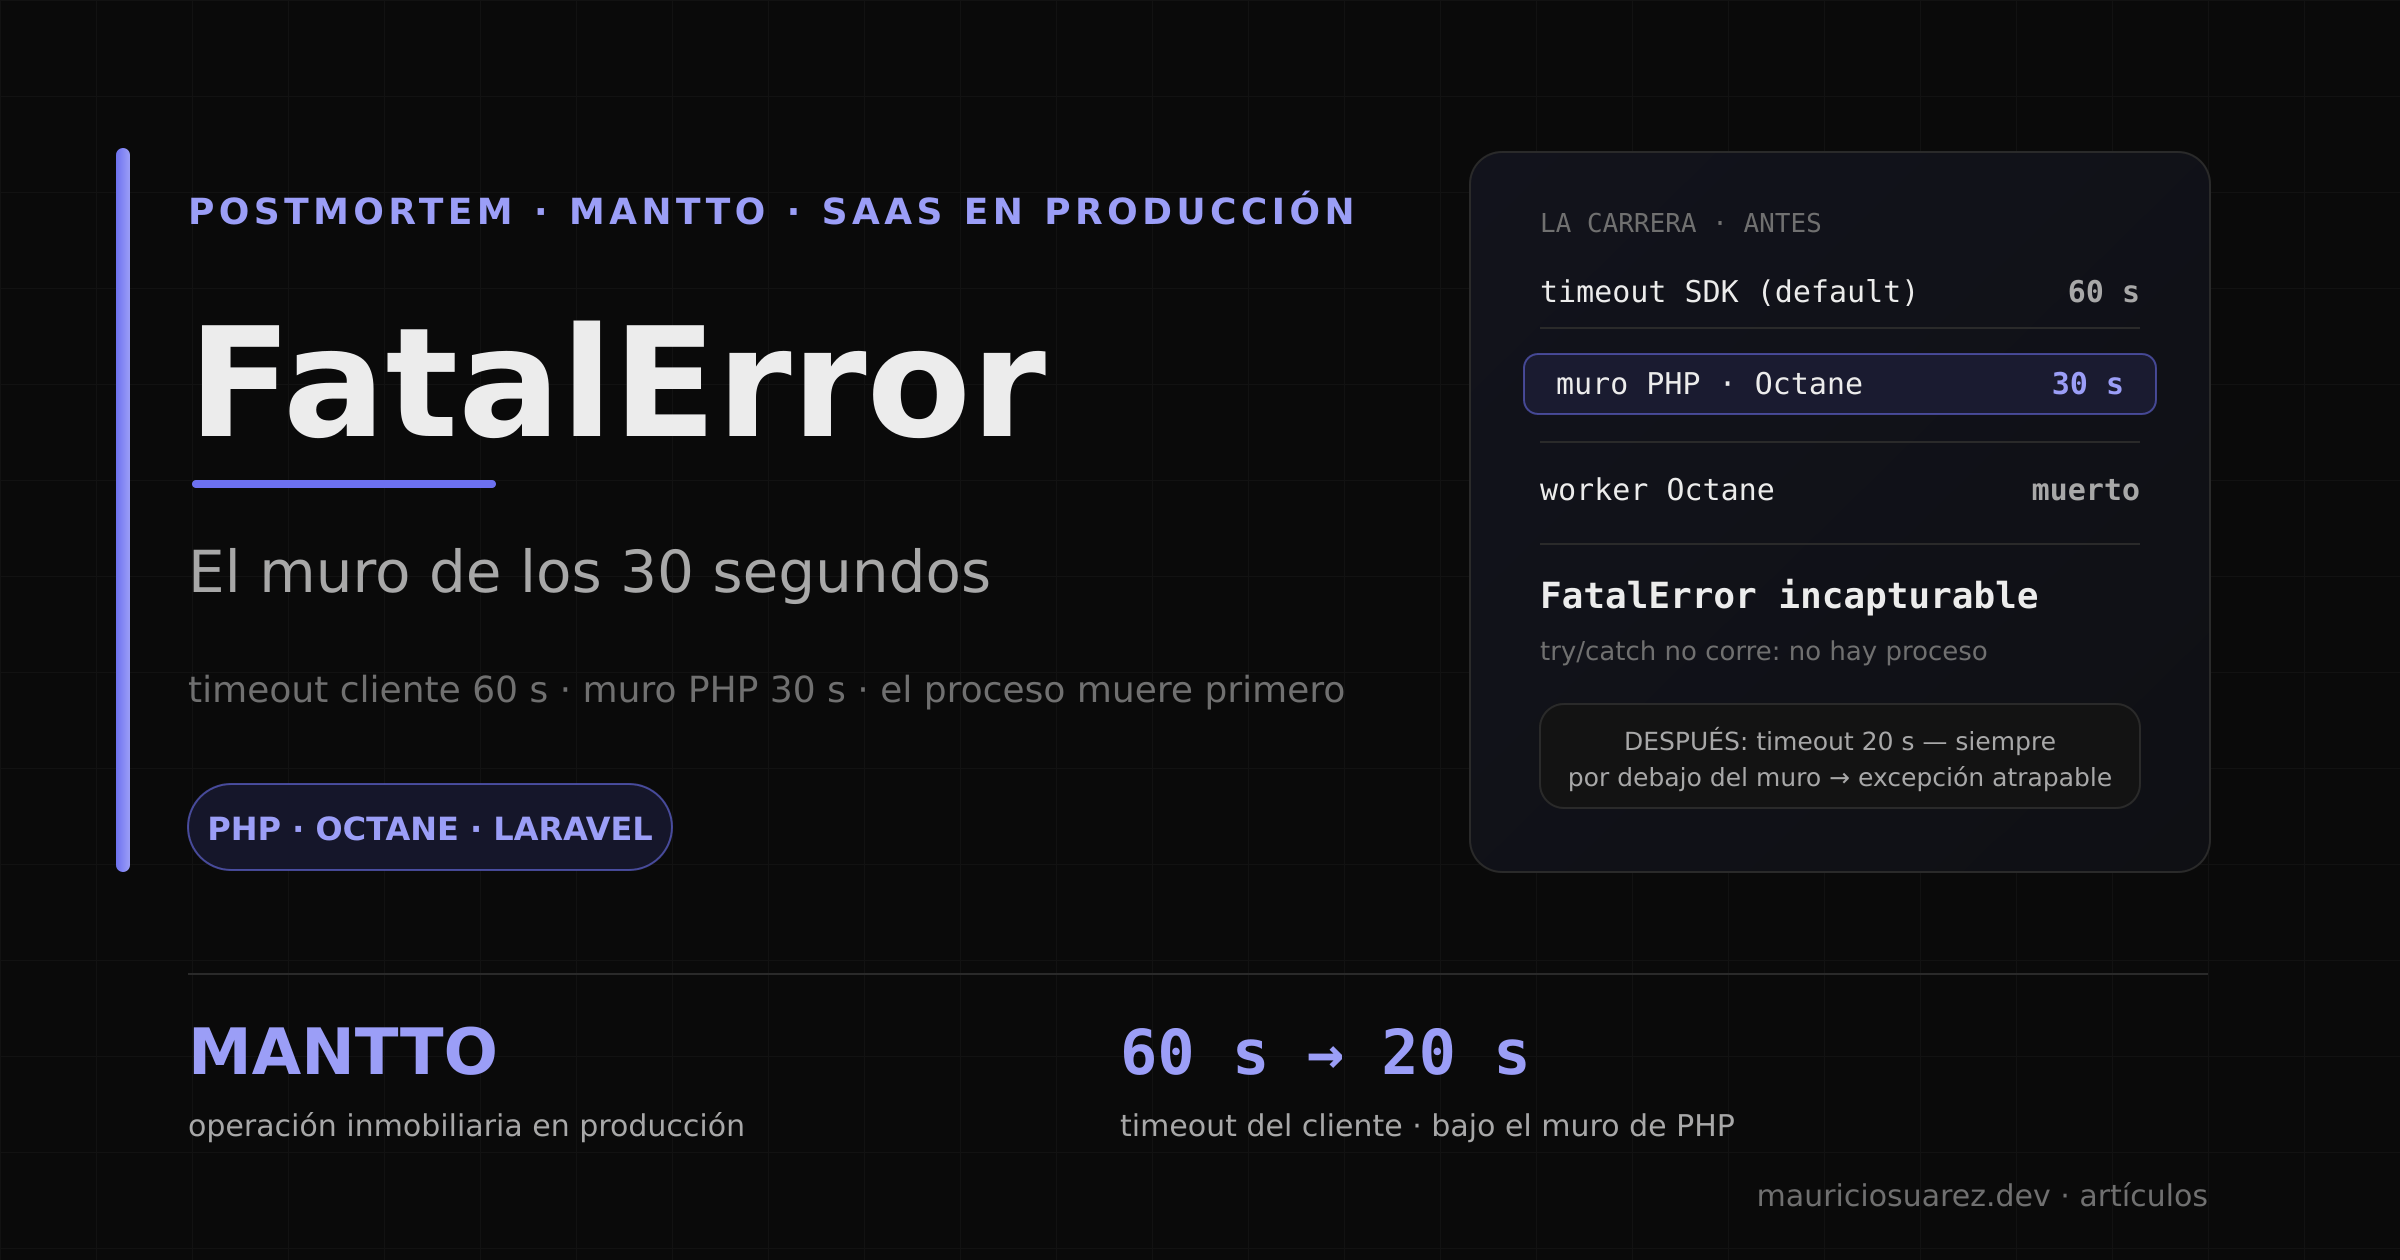
Hace dos días Sentry me notificó una muerte. No un error — una muerte: FatalError: Maximum execution time of 30 seconds exceeded, worker de Octane caído, y seis reinicios ruidosos en los logs (ERROR unknown error ×6). Lo más inquietante: el código tenía try/catch. El gateway de IA tenía su cadena de failover. Nada pudo actuar — porque nada de eso corre cuando el proceso ya está muerto.
El sistema es Mantto, el mismo SaaS de mantenimiento inmobiliario de la entrada anterior. Esta vez el protagonista no es un endpoint lento sino un límite que nadie estaba mirando.
Lo que (bien) queda síncrono
En el episodio pasado moví 29 segundos de trabajo a la cola y el endpoint quedó en menos de 500 ms. Conclusión tentadora: “todo lo lento va a la cola”. Falso — y el contraejemplo vive en tres endpoints de IA interactivos: mejorar una nota, mejorar una descripción, clasificar un mantenimiento. Son síncronos a propósito: el usuario está mirando el resultado aparecer en pantalla. No hay cola que ayude cuando la respuesta tiene que estar en esta respuesta.
Ese es el escenario. Una llamada a Gemini que se colgó. Un timeout de cliente que jamás se disparó. Y un muro.
Una muerte, no un error
La diferencia importa más de lo que parece. Una excepción es el programa hablando: alguien puede atraparla, loguearla, degradar con elegancia. Un FatalError de timeout del engine es otra cosa: lo lanza Zend, por debajo de PHP, cuando max_execution_time se agota. No pasa por tu código, no respeta tu stack de handlers, no llega al catch. El worker de Octane —que en producción corre con max_execution_time = 30— simplemente muere a los 30 segundos, y el supervisor lo reinicia.
Por eso el try/catch estaba y no sirvió de nada: opera en el ámbito del lenguaje; el muro lo decide el engine. No existe catch para “se acabó el proceso”.
La autopsia: una cadena de tres eslabones
Sentry issue 7753074600, POST /api/v1/ai/improve-description, stack completo a través de Prism → Guzzle. La cadena causal, reconstruida:
NoteImprovementService::improveDescription()llamaba aTextGateway::prompt()sin timeout explícito.- La SDK de Laravel AI aplica un default de 60 segundos para prompts de texto cuando nadie lo setea (
Promptable::getTimeout()). - El worker HTTP de Octane muere a los 30 segundos —
max_execution_timede PHP — con unFatalErrorincapturable. La SDK, pacientemente esperando su minuto, jamás llegó a dispararse.
De ahí la ley que gobierna cualquier llamada saliente lenta desde contexto HTTP:
Si el timeout del cliente ≥
max_execution_time, PHP gana siempre. No degrada: mata.
Tu cliente pensó en todo… para el segundo 60. El proceso dejó de existir en el 30.
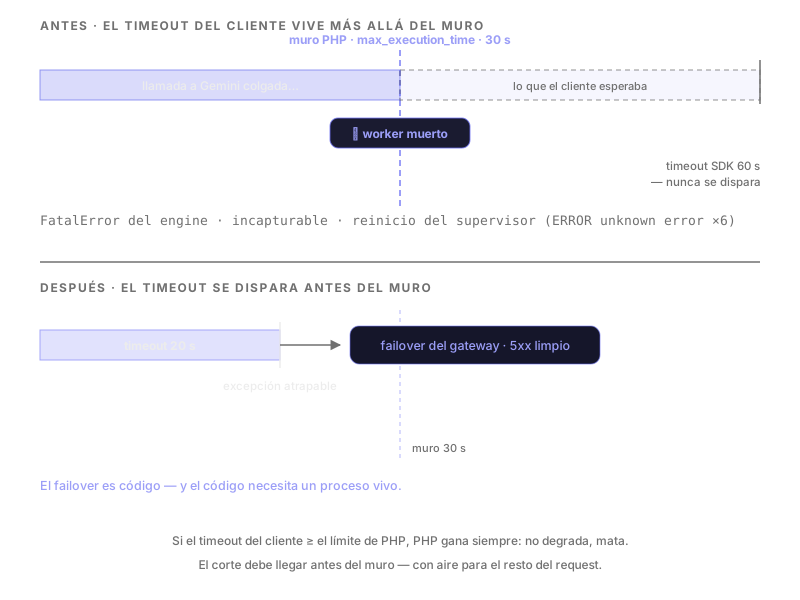
La carrera que siempre se pierde: mientras tu timeout de cliente viva más allá del muro, el engine te mata antes de que tu propia defensa se dispare. En celular, deslizá el gráfico para verlo completo.
El fix: 20 segundos, siempre debajo del muro
La solución no fue más try/catch — ya vimos que no hay dónde ponerlo. Fue devolverle la carrera al lenguaje:
TextGateway::prompt()ahora acepta un?int $timeouty lo forwardea hasta Guzzle vía Prism.- Los tres endpoints síncronos pasan
config('ai.gateway.http_prompt_timeout')— envAI_HTTP_PROMPT_TIMEOUT, default 20 s, estrictamente por debajo de los 30 del muro. - Un timeout que se dispara es una falla normal de ruta: excepción atrapable, no fatal del engine.
¿Por qué 20 y no 29? Porque el muro de 30 s no es del llamado a IA — es del request completo. El presupuesto incluye validación, base de datos, serialización. El timeout del cliente tiene que dejar aire al resto del request, no apenas raspar el muro.
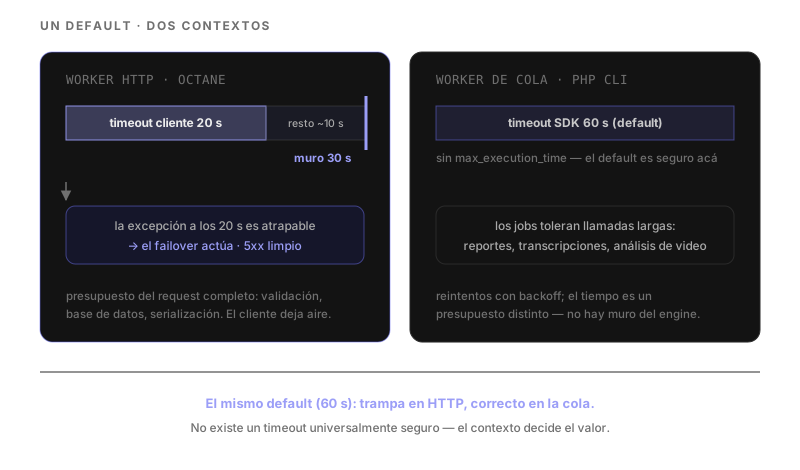
El mismo default (60 s) es una trampa en un contexto y una decisión correcta en el otro. El contexto decide el valor — no hay timeout universalmente seguro.
El giro: el failover por fin respira
Esta es la parte que más me gusta del fix. El gateway de Mantto tiene, desde hace meses, una cadena de failover con tope: si una ruta falla, avanza a la siguiente; si todas fallan, un 5xx limpio y auditable.
Era una buena defensa… que en el incidente no pudo ejecutarse ni una vez. El failover es código, y el código necesita un proceso vivo. Con el timeout en 20 s, el colgado de Gemini se convierte en una excepción a los 20 segundos, el gateway avanza de ruta, y el contrato de error se cumple. La defensa que ya tenía construida por fin tiene espacio para actuar.
Los gotchas, en corto
- El default de la SDK es una trampa reposicionada. 60 s sigue siendo el default para cualquier caller nuevo que olvide el timeout en contexto HTTP — el fatal puede volver a introducirse con un endpoint nuevo. La defensa: un regression test que espía el gateway y afirma que todo prompt HTTP llega con timeout acotado (< 30), más la tabla de timeouts del runbook.
- Deploy con Octane = contrato de reinicio (lo dejé documentado en la entrada anterior):
config/ai.phpcambió →docker compose restart api worker. - ¿Cómo supe que el fatal era del deploy de esta semana y no de uno viejo? Porque un mes antes resolví otro misterio: durante semanas, seis deploys compartían el mismo release en Sentry y el triage “¿qué deploy rompió esto?” era imposible. Esa historia — el release congelado — es la próxima entrada de esta serie.
Lo transferible
- Los timeouts son una jerarquía: paciencia del usuario > presupuesto del request > límite duro del runtime > timeout del cliente. El cliente va siempre debajo del muro, con aire para el resto del request.
try/catchvive dentro del proceso — el proceso no es eterno. Existe una zona incapturable; el diseño correcto no intenta atraparla, sino no llegar nunca a ella.- Un default seguro en un contexto es una trampa en otro. 60 s: razonable en un worker de cola sin límite, fatal en un request con muro. El contexto decide.
- El failover es un mecanismo de proceso vivo. Ninguna cadena de fallback vale nada si el primer fallo mata al proceso que la iba a ejecutar.
- Un límite duro no documentado es un incidente programado. El muro llevaba meses ahí; nadie lo había puesto en la misma página que los timeouts de cliente.
Dos honestidades de cierre: esto es un registro interno de producción, no un benchmark — un solo llamado colgado lo destapó, lo que también dice algo de la cola de incidentes que espera a los defaults no examinados. Y el fix es deliberadamente aburrido: un parámetro que viaja, una config con default conservador y un test que vigila la puerta. Los fixes buenos suelen ser eso.
¿Y por qué durante semanas no pude hacer triage por deploy? Porque todos los eventos de Sentry caían en el mismo release — uno de julio — sin importar el commit desplegado. Seis deploys, un release congelado, y una cadena de precedencias de variables que casi nadie entiende. Esa es la próxima entrada.