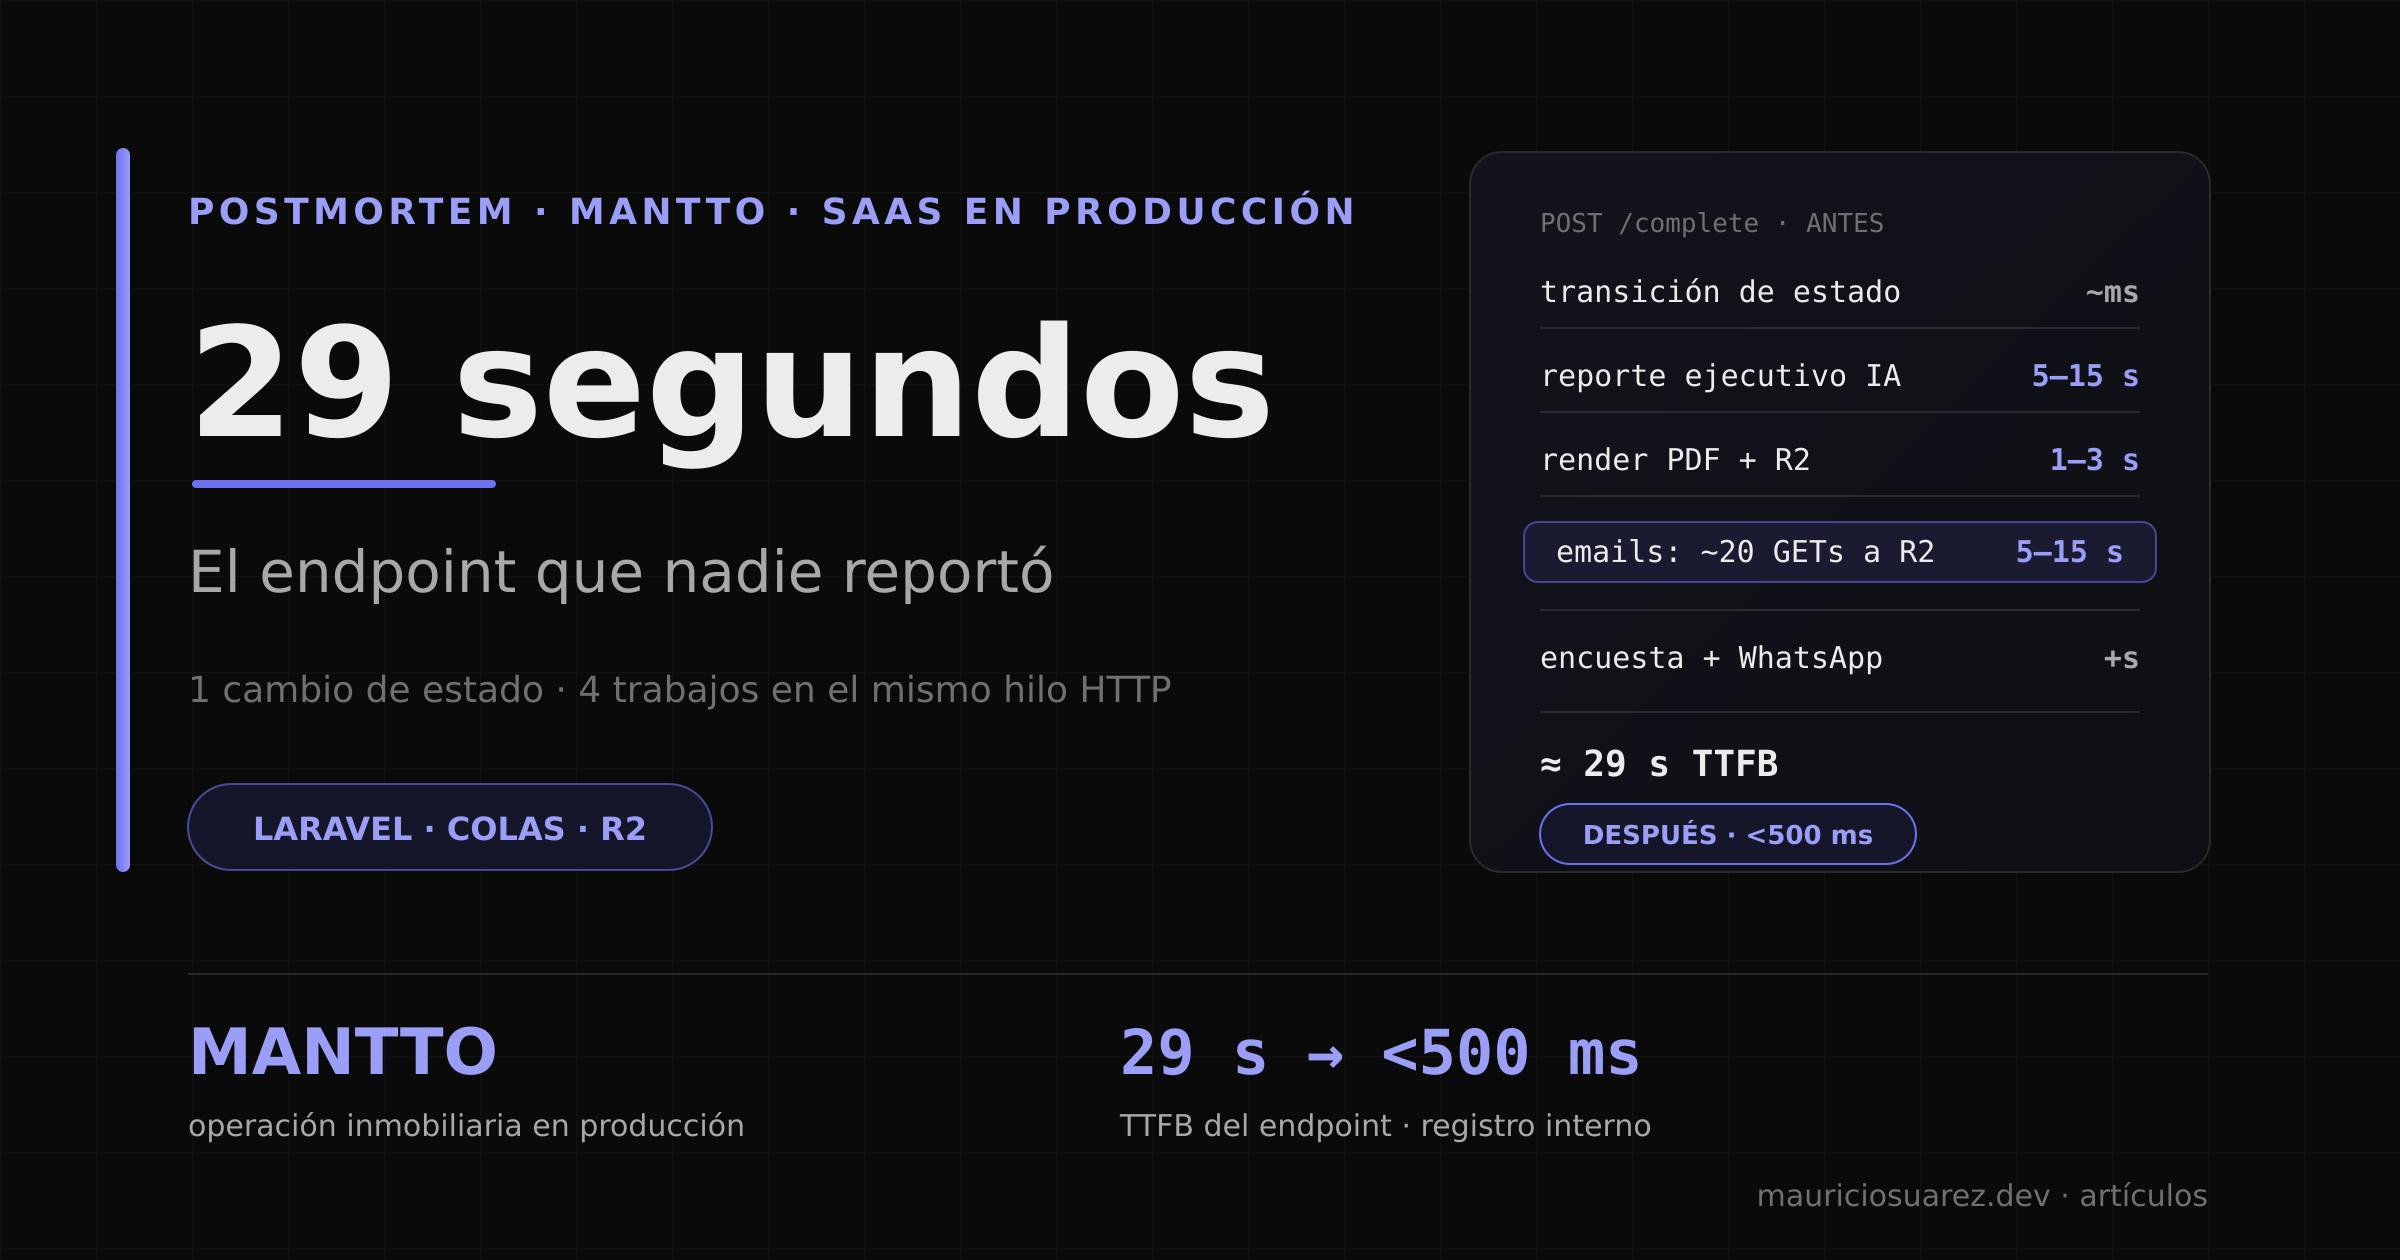
El endpoint más importante de mi SaaS tardaba 29 segundos en responder. Lo sé porque lo medí — no porque alguien lo reportara. Nadie se quejó nunca. Ese silencio es la parte más interesante de esta historia.
El sistema es Mantto, una plataforma de mantenimiento e inspecciones inmobiliarias que corre en producción. El endpoint en cuestión es el que marca un mantenimiento como completado: el botón que un administrador aprieta al cerrar el día. Suena trivial. No lo es.
El síntoma que nadie reportó
POST /api/v1/maintenance-requests/{id}/complete respondía en ~29 segundos de TTFB en producción. El spinner giraba medio minuto y el usuario esperaba, porque “está generando el reporte” parecía una razón razonable. El retraso se había normalizado: cuando lo lento es lo de siempre, deja de ser un bug y pasa a ser una feature de la espera.
No hubo ticket, no hubo reclamo. Hubo una medición interna y una sospecha: ningún endpoint debería tardar 29 segundos en actualizar un estado.
¿Y por qué importaba, si nadie se quejaba? Porque el botón de completar es el que cierra el día: un spinner de medio minuto invita al segundo click —y con él al riesgo del registro duplicado—, y después a la duda de si el trabajo quedó registrado. La lentitud normalizada entrena a desconfiar del sistema justo en el momento en que más importa: cuando certifica que un trabajo terminó.
La autopsia: cuatro trabajos en un solo hilo HTTP
Al abrir completeExecution() encontré el problema de raíz: la transición de estado era solo la primera línea. Todo lo demás — el fan-out post-completado — corría síncronamente dentro de la petición HTTP:
| # | Trabajo | Costo | Detalle |
|---|---|---|---|
| 1 | Reporte ejecutivo con IA | ~5–15 s | Llamada a OpenAI/Gemini vía el gateway de IA de la app |
| 2 | Render PDF + subida a R2 | ~1–3 s | DomPDF renderiza el reporte y lo sube a Cloudflare R2 |
| 3 | Dos emails de confirmación | ~5–15 s | El criminal escondido — detalle abajo |
| 4 | Encuesta de satisfacción | segundos | Otro email síncrono + WhatsApp |
El criminal escondido era el #3. Los emails de confirmación adjuntaban la evidencia del trabajo (fotos de antes y después). El build() del mailable hacía un GET a R2 por cada archivo adjunto: con ~10 imágenes × 2 destinatarios son ~20 descargas secuenciales desde object storage, más la llamada síncrona a Resend para enviar. Todo dentro de la petición HTTP original, sin ShouldQueue.
Hay una ironía deliciosa: las notificaciones de WhatsApp ya eran asíncronas desde el principio. El cuello de botella no era la IA ni el PDF — eran los emails, el componente que nadie sospecha porque “un email no puede tardar 15 segundos”. Puede. Cuando un email es, en realidad, un cliente de object storage disfrazado.
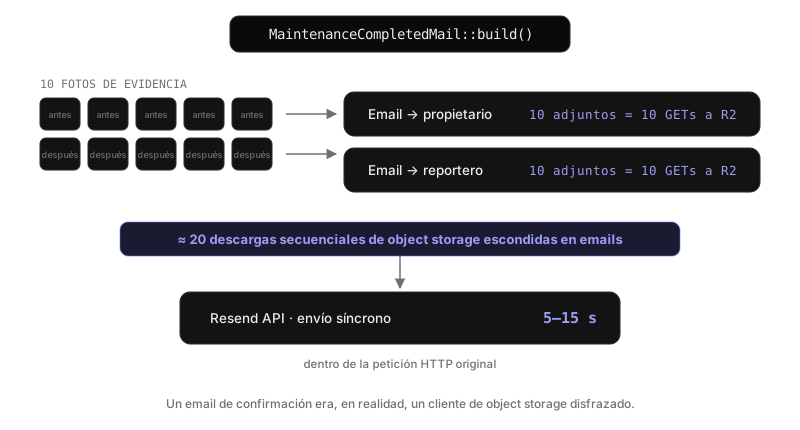
Anatomía del criminal escondido: cada email adjuntaba 10 fotos descargándolas una por una de R2 — dos destinatarios, ~20 GETs secuenciales — más el envío síncrono. Todo dentro de la petición HTTP original.
La suma: 29 segundos de trabajo legítimo ejecutado en el peor lugar posible.
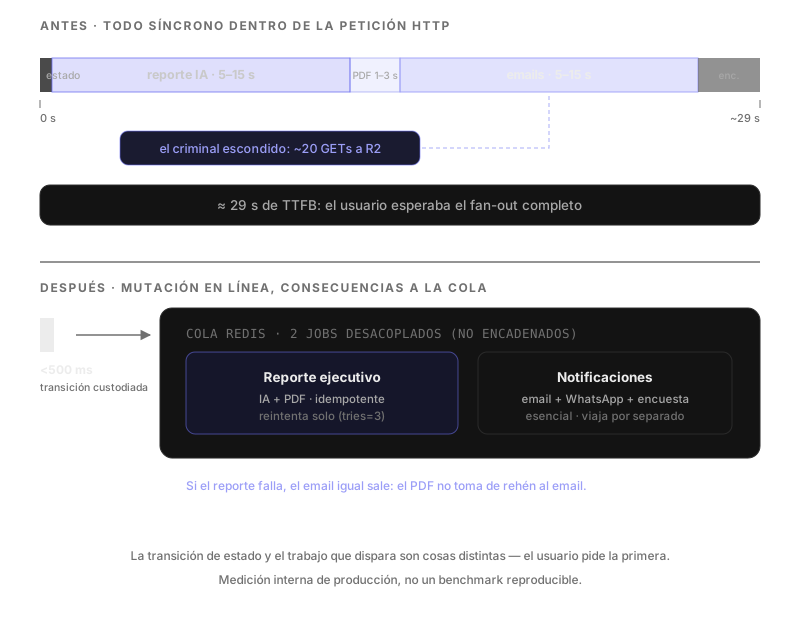
Arriba, la autopsia completa; abajo, el patrón que la reemplazó. En celular, deslizá el gráfico horizontalmente para verlo completo.
El fix: mutá rápido, desparramá después
El patrón que apliqué es viejo y merecidamente famoso — haz la mutación de estado en línea, el resto a la cola — pero los detalles son los que deciden si sobrevive a producción:
1. En línea, solo la mutación custodiada. La transición de estado con su transacción y lockForUpdate, más el trabajo rápido de base de datos que ya estaba protegido. Nada más.
2. Los mailables implementan ShouldQueue. Una interfaz, y las ~20 descargas de R2 + el envío migran al worker. Mail::to()->send() los encola automáticamente.
3. Un job por preocupación, desacoplados — no encadenados. Consideré Bus::chain([reportJob, notifyJob]) y lo rechacé: si el job del reporte reintenta (lanza), la cadena se rompe y el email nunca se envía. El email es esencial; el PDF es un nice-to-have. Desacoplados, el email procede por su cuenta y el reporte reintenta solo (tries=3, idempotente — si ya existe, salta). El job de notificaciones incluso omite el PDF gracefully si el reporte aún no terminó.
4. El dispatch también puede fallar. El cambio de estado ya está comprometido cuando despacho los jobs; si Redis está caído en ese instante, la petición no debe crashear ni esconder un estado completado:
try {
    GenerateMaintenanceExecutiveReportJob::dispatch($mr->id, $user->id);
    SendMaintenanceCompletionNotificationsJob::dispatch($mr->id, $user->id);
} catch (\Throwable $e) {
    report($e); // para reconciliación de ops; el backstop manual es
                // el endpoint admin de "regenerar reporte"
}
return $maintenanceRequest->refresh();
Resultado: la petición responde en <500 ms. Los ~29 segundos de trabajo siguen existiendo — ahora corren en la cola de Redis, donde pertenecen.
Los gotchas, en corto
El cambio trajo tres trampas que no aparecen en ningún tutorial (guárdalas si aplicás el patrón):
Mail::assertSentdeja de funcionar apenas el mailable implementaShouldQueue:Mail::fake()lo registra como queued — toca usarMail::assertQueued(...).- Los jobs en tests corrían en la cola REAL:
phpunit.xmlseteaQUEUE_CONNECTION=syncvía<env>, pero<env>no puebla$_SERVER— gana elredisdel contenedor, los fakes no aplican dentro dehandle()y un test terminó subiendo a R2 real (~22 s por test). Patrón robusto:Queue::fake()+assertPushed()sin ejecutar, o instanciar el job y llamarhandle()directo. - Deploy con Octane:
docker compose restart api worker(cachea config/middleware) +php artisan queue:restart— sin eso, despachás jobs que ningún worker conoce todavía.
Lo transferible
- El silencio no es salud, es normalización. Medí porque desconfié del spinner, no porque fallara algo. “Siempre tardó así” es la frase más cara de un SaaS.
- La transición de estado y el trabajo que dispara son cosas distintas. El usuario pide un cambio de estado; el reporte, el PDF y los emails son consecuencias. Las consecuencias no necesitan bloquear la confirmación.
- Encadená solo lo que de verdad es secuencial. Un
chainelegante puede costarte el email esencial por culpa del PDF opcional. Esencial y nice-to-have viajan separados. - Los emails son código. I/O en
build()es I/O en tu request. Cada adjunto es una descarga de red que pagás en latencia — o en la cola. - Protegé lo ya comprometido. Si el estado se guardó, un fallo al despachar las consecuencias es un incidente de reconciliación, no un error 500 para el usuario.
Dos honestidades antes de cerrar: el 29 s → <500 ms es un registro interno de producción, no un benchmark reproducible (un solo operador, volumen bajo en ese momento — parte de la lección es que el dolor no necesita volumen para existir). Y la solución no fue inventar nada: fue respetar un patrón que Laravel regala y aplicar disciplina en los bordes.
Epílogo con gancho: semanas después de este fix, otro llamado a IA — este sí con timeout — me enseñó que hay errores que ningún try/catch puede atrapar, porque el proceso ya está muerto cuando ocurren. Esa es la siguiente entrada de esta serie.