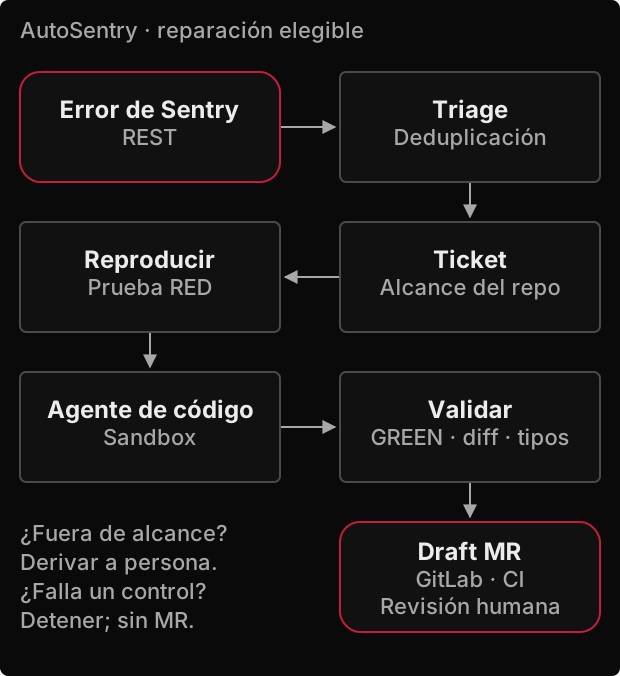
Trabajé en una herramienta interna que conecta errores de Sentry con correcciones preparadas para revisión humana. El proyecto aborda el recorrido previo a la revisión de código: seleccionar un problema accionable, evitar duplicados, localizar el código relevante, reproducir el fallo y preparar un cambio que un ingeniero pueda evaluar.
Base de evidencia: RFC, README y configuración Wrangler suministrados. La revisión de fuentes no inspeccionó el repositorio completo, merge requests ni un despliegue remoto. El caso de herramienta interna está anonimizado.
Triage antes de automatizar
El flujo comienza con triage determinista. Los eventos se filtran para distinguir problemas de la aplicación de ruido de red, bloqueadores y dependencias externas. Los defectos se agrupan para que varias manifestaciones no generen tickets repetidos. Un manifiesto relaciona el error con los repositorios y el alcance permitido; los casos fuera de ese alcance se derivan a una persona.
Un fallo temprano cambió el diseño. Un intento de reparación basado en generar un parche de una sola vez sustituyó un archivo grande por un fragmento mínimo. La revisión del borrador detectó el problema y el cambio se cerró sin integrarse. Esa experiencia motivó pasar a un agente de programación que trabaja sobre archivos reales dentro de un sandbox, con comprobaciones explícitas antes de crear una propuesta de cambio.
Dos recorridos del flujo
- Fuera de alcance: un defecto que no puede asociarse a un repositorio autorizado pasa a una persona, no al agente de programación. El ruido de red, bloqueadores y terceros se filtra durante el triage.
- Defecto elegible: tras triage y deduplicación se crea un ticket, una prueba RED, una reparación en sandbox y controles antes del draft MR de GitLab. Siguen CI y revisión humana; el agente no integra ni despliega la corrección.
- Backend en modo de reporte: la ampliación documentada a backend solo clasifica y reporta. No crea tickets ni activa intentos automáticos de reparación.
Arquitectura
La orquestación documentada utiliza una máquina de estados sobre Durable Objects con el Agents SDK de Cloudflare y almacenamiento SQLite, mientras un agente de programación ejecuta las fases de reproducción y reparación dentro de un contenedor de Cloudflare Sandbox. La lógica determinista de clasificación y deduplicación se mantiene separada del agente que edita el código. El modelo trabaja dentro de etapas delimitadas; el código de orquestación decide cuándo puede avanzar el proceso.
La separación de capacidades también forma parte del diseño. Las salidas de red están limitadas, con credenciales incorporadas a las peticiones autorizadas por un componente fuera del sandbox. El agente prepara un merge request en borrador; la aprobación del merge y la integración quedan en manos de una persona. Las convenciones de desarrollo se seleccionan según repositorio y fase mediante referencias a un conjunto pequeño de skills de solo lectura — añadir esos documentos al contexto no concede herramientas nuevas ni acceso a sistemas internos.
Una corrección debe demostrarse
Una corrección propuesta supera una secuencia concreta:
- Una prueba de reproducción falla contra el código original (RED)
- El agente realiza el cambio; la prueba debe pasar (GREEN)
- Un control del tamaño del diff detecta eliminaciones masivas
- El chequeo de tipos compara contra el baseline existente para identificar errores nuevos
- Tras los controles locales sigue el CI habitual y la revisión humana
Si no se reproduce el fallo o no se supera un control de validación, ese intento se detiene antes de abrir un draft MR. Que el modelo genere una edición no es suficiente para avanzar.
El proceso puede continuar después de abrir el borrador. Un ciclo de revisión limitado e invocable puede seleccionar comentarios pendientes de CodeRabbit, aplicar una corrección dentro del mismo alcance y repetir los controles antes de actualizar el mismo merge request. En repositorios con submódulos, el flujo respeta el proceso de entrega existente: propone la corrección en el repositorio compartido y deja la actualización de referencias para el release posterior al merge.
Evolución operativa
El piloto evolucionó del triage y la ejecución manual a un encadenamiento automático con límites de frecuencia, presupuesto y concurrencia. Antes de activar un intento automático, el diseño reserva el coste máximo de sus dos fases y lo concilia con el gasto reportado al terminar. Estos límites son del encadenamiento automático; la ruta manual tiene un contrato separado. La configuración suministrada describe el piloto automático, no un despliegue actual verificado remotamente. La elección del runtime también tuvo una frontera práctica: Cloudflare permitía ejecutar el piloto, mientras los diagnósticos que necesitan acceso a redes internas se reservaron para otro entorno; el despliegue reproducible quedó a cargo del equipo de DevOps, trabajo distinto del diseño y evolución del flujo de reparación.
Resultados reportados y límites
El RFC registra correcciones integradas después de revisión humana, junto con una corrección parcial cuyo caso simétrico seguía pendiente — evidencia tanto de la utilidad del sistema como de la necesidad de revisar el alcance real de cada reparación. Este caso se basa en el RFC, README y configuración de despliegue del proyecto; no es una auditoría independiente y no reporta tasas agregadas de precisión ni costes medios por reparación.
A diferencia del enfoque de revisión en GitHub de DonMerge, este caso sigue un defecto por reproducción y reparación hasta un draft MR de GitLab. Su runtime documentado utiliza Agents SDK, Durable Objects y Sandbox, no Cloudflare Workflows. DonMerge también contiene triage y auto-fix: no se presentan capacidades exclusivas ni se transfieren resultados entre ambos.
AutoSentry representa mi enfoque de IA aplicada al desarrollo: convertir un problema observado en una propuesta de cambio verificable, con contexto de repositorio, controles de ejecución y una decisión humana explícita al final.