DonMerge integra revisión de código con IA en el flujo de pull requests. Mi trabajo abarcó la integración con GitHub, el tratamiento de los hallazgos y la evolución de la ejecución hacia un proceso duradero con recuperación explícita ante fallos.
Contexto y contribución
El primer estado conservado en el repositorio, de marzo de 2026, contiene un revisor por webhook construido sobre Flue. Esa fecha describe el historial disponible, no necesariamente el inicio del producto. Los cambios posteriores muestran el trabajo necesario alrededor de esa primera capacidad: reconocer problemas ya señalados, distinguir observaciones útiles de ruido y completar revisiones cuando fallan proveedores o infraestructura.
Mi contribución consistió en hacer explícitos esos límites, en lugar de tratar una respuesta exitosa del modelo como una revisión terminada. Flue, los modelos y Cloudflare aportan capacidades de base; aquí describo el trabajo de integración, ciclo de vida de hallazgos y políticas de ejecución.
Los hallazgos necesitan identidad
En marzo incorporé deduplicación y seguimiento del ciclo de vida de los hallazgos. Repetir una revisión no debería llenar el PR de comentarios sobre el mismo problema. El sistema necesita continuidad entre ejecuciones, además de interpretar el diff actual.
Las claves estables permiten que los hallazgos conserven su identidad al repetir una revisión. Seguir su ciclo de vida también hace visibles los problemas pendientes: una nueva pasada no debe borrar silenciosamente la importancia de una observación anterior. Así, los mensajes aislados del modelo se convierten en estado de revisión que un ingeniero puede seguir y resolver.
Decidir qué puede bloquear un cambio
La calidad de la revisión se convirtió en un problema de ingeniería independiente. Una revisión de calidad documentada en julio motivó una capa determinista posterior a la respuesta del modelo. Esta capa filtra comentarios genéricos o de estilo y exige describir un mecanismo de fallo para los hallazgos críticos. Las recomendaciones no bloqueantes reciben otro tratamiento.
Son heurísticas explícitas y comprobables, no una demostración de que cada hallazgo retenido sea correcto. Sus límites todavía necesitan evaluación. El control busca separar riesgos accionables de ruido antes de publicar comentarios y checks en GitHub.
Sacar la ejecución de la petición HTTP
Migré la orquestación basada en alarmas de Durable Objects a Cloudflare Workflows. Un fallo posterior mostró que iniciar trabajo largo desde la vida de una petición HTTP podía dejar revisiones sin arrancar. Separar la recepción del webhook mediante una cola dio una responsabilidad clara a cada parte: el endpoint acepta el evento; un consumidor gestiona el procesamiento y los reintentos.
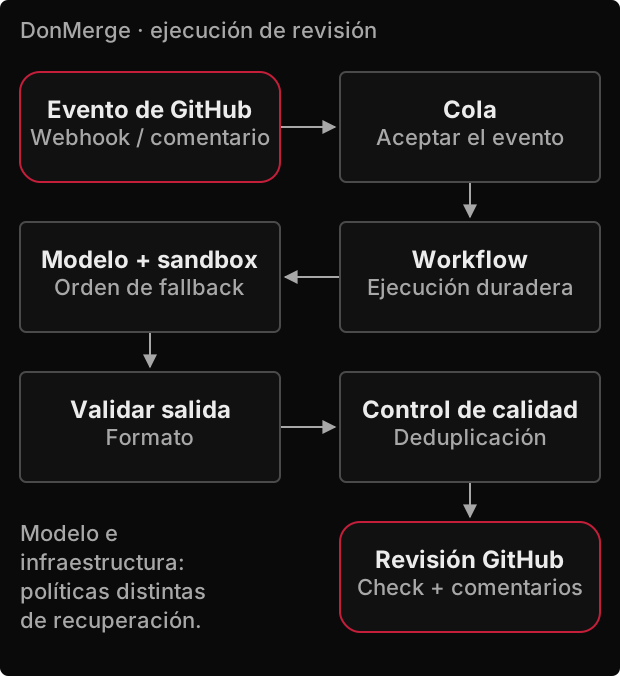
El recorrido de una revisión es:
- Se acepta y encola un evento de GitHub.
- Un Workflow obtiene los datos del PR y prepara archivos y contexto.
- El modelo revisa el cambio dentro de un sandbox.
- La validación de salida, el control de calidad y el emparejamiento de hallazgos determinan qué publicar.
- GitHub recibe el check run y los comentarios por línea.
Después traté las entregas duplicadas y la distinción entre trabajo nuevo y una revisión ya activa. Incorporé limpieza explícita de los sandboxes para liberar recursos al terminar, sin descartar una revisión válida cuando falla su limpieza.
Dos políticas de reintento distintas
Las respuestas lentas de los proveedores hicieron visible otro límite: los reintentos de modelos y de infraestructura necesitan políticas diferentes. Separé el orden de modelos, la validación de salida y la reparación de formato en un componente de ejecución dedicado.
Agotar la cadena de modelos deja de provocar que el Workflow repita toda esa cadena. Los fallos de infraestructura mantienen su tratamiento recuperable. Así se evita multiplicar intentos de modelo simplemente porque una capa exterior también sabe reintentar.
Evidencia y límites
La historia se apoya en historial Git inspeccionado, diffs seleccionados y el registro de validación en producción de agosto. Ese registro histórico documenta una revisión completada en 7m15s, hallazgos accionables y un grupo de seis ejecuciones inicialmente fallidas que completaron al repetirse. No establece un benchmark general de velocidad, precisión o fiabilidad; esas ejecuciones no se repitieron para esta actualización del portfolio.
DonMerge también contiene triage y auto-fix. Este caso se centra en la revisión de GitHub mediante Workflows. AutoSentry es otro flujo documentado de reparación, basado en Agents SDK, Durable Objects y Sandbox, que termina en merge requests de GitLab en borrador. Sus resultados y evidencias no son intercambiables.
El proyecto refleja mi forma de trabajar con IA aplicada: integrar el modelo en un proceso real y hacer explícitos el estado, las decisiones de publicación y la recuperación. Los checks y estados automáticos apoyan la decisión del equipo, no sustituyen el criterio de ingeniería.